大 PDF 喂给模型:先算 Token 预算,再决定整篇放入还是分块
把一份几百页的 PDF 直接丢给模型,常见的结果有三种:请求被拒绝、费用超出预期、或者回答里漏掉了文档中段的关键内容。根源都在于没有先算清上下文窗口和 Token 预算。上下文窗口要同时装下系统提示、文档、问题和模型的输出,输出里还包含推理消耗的部分。本文对照 Anthropic 与 OpenAI 的官方文档(核验日期 2026-09-20),讲清 PDF 是怎样被计入 Token 的、页数与体积限制在哪里,以及分块、检索与整篇放入三种做法各适合什么场景。
PDF 是怎么变成 Token 的
文本和页面图像会同时计入
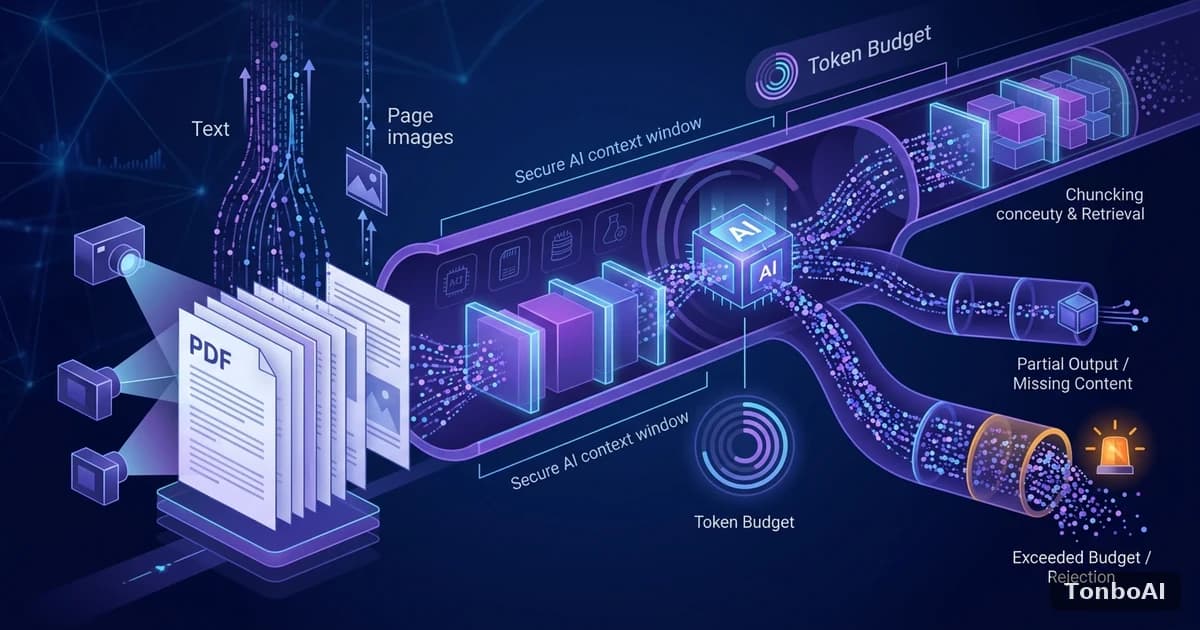
两家的处理方式相近。OpenAI 文档说明,PDF 会同时提取文本和页面图像并一并送给模型,所以比纯文本输入更耗 Token,图像精细度参数设为 low 可以减少消耗,设为 high 则保留密集图表和小字的细节。Anthropic 文档同样说明,每一页既按提取出的文本计费,也因为被转成图像而按图像规则计费,标准 API 定价,没有额外的 PDF 附加费用。文本部分,文档给出的量级是每页约 1,500 到 3,000 Token,取决于内容密度。
体积与页数的硬限制
| 项目 | Anthropic | OpenAI |
|---|---|---|
| 单次请求体积 | 最大 32 MB,各平台可能不同 | 单个文件小于 50 MB,一次请求内所有文件合计 50 MB |
| 页数 | 单次最多 600 页;当请求的上下文窗口小于 100 万 Token 时为 100 页 | 文档未在本次核验的页面给出页数上限 |
| 上传方式 | 可用 Files API 上传后以 file_id 引用,减小请求体积 | 可先上传拿到文件 ID,也可直接用 base64 |
| 大文件建议 | 密集 PDF 可能在触及页数上限前就填满上下文,建议拆成多个部分,并可压缩嵌入图片 | 对超大文件建议使用文件检索,而不是整份作为输入文件传入 |
| 表格类文件 | 不适用 | 电子表格每个工作表只解析前 1,000 行 |
请注意 Anthropic 文档的一个提醒:即使使用 Files API,含大量密集页面的请求也可能在达到页数上限之前失败,此时应把文档拆成若干部分处理。
上下文窗口与 Token 预算怎么算
窗口装的是输入加输出,而不只是文档
Anthropic 文档说明,请求中的一切都计入上下文窗口:系统提示、每一条消息、工具结果、图片与文档,以及本轮生成的输出,包括思考。较新的一批模型上下文窗口可达 100 万 Token,其他模型如 Sonnet 4.5 为 200,000 Token,请以模型对照表为准。如果仅输入就已超出窗口,接口会返回 400 的 invalid_request_error,提示 prompt is too long;对 Claude 4.5 及之后的模型,输入加 max_tokens 超出窗口时请求仍会被接受,生成到窗口上限时以 model_context_window_exceeded 作为停止原因结束,较早的模型则会直接返回校验错误。
窗口更大不等于回答更准
同一篇文档还指出,随着 Token 数增长,准确度与召回会下降,这种现象被称为 context rot,所以整理进入上下文的内容与窗口容量同样重要。这意味着即使模型能装下整份文档,也不一定应该整份放入:与问题无关的章节、页眉页脚、目录和重复的免责声明,都会占用预算并稀释关键信息。
用一个假设数字走一遍预算
下面的数字为演示而假设,不是实测:窗口 200,000 Token;为输出和推理预留 24,000;系统提示与问题合计 4,000;剩余 172,000 给文档。若按每页 2,000 Token 估算,可放入约 86 页。真实项目里应先用官方的 Token 计数接口对文档做一次计数,因为页面图像的成本没有包含在这个演示里。
- 预留输出要按最坏情况算:思考与回答共用输出上限,预留不足会导致回答被截断。
- 多轮追问时,历史会不断累积,每一轮都要重新核对剩余预算。
- 缓存命中的前缀依然占用窗口,缓存改变的是计价,不是占用。
三种做法:整篇放入、分块汇总、检索
| 做法 | 适用场景 | 主要代价 |
|---|---|---|
| 整篇放入 | 单份文档在预算内,需要跨章节推理或对照前后文 | 每次请求都带全文,需要配合提示词缓存控制成本 |
| 分块加汇总 | 文档超预算,或需要逐章提取结构化信息 | 跨块的关联信息可能丢失,需要设计汇总步骤 |
| 检索后再回答 | 文档很多、很长,问题只涉及其中少量段落 | 依赖检索质量,检索漏掉的内容模型看不到 |
分块的四个要点
- 按文档自身结构切分,例如章节标题、条款编号,而不是按固定字数硬切,避免把一个表格或一段论证拦腰截断。
- 相邻块保留一小段重叠,并在每块前附上所属章节与页码,方便回溯引用。
- 每块的大小按预算反推:单块输入加预留输出不超过窗口的一个安全比例,并用 Token 计数接口核对,而不是用字符数估算。
- 汇总阶段不要只拼接各块摘要,最好让模型显式列出各块之间的冲突与依赖,再给出结论。
输入前的清理同样重要
页眉、页脚、目录、重复的页码和扫描件产生的乱码,会消耗预算而不增加信息。对扫描版 PDF,先确认文字是否可提取;对图表很多的文档,可以只保留与问题相关的页面,并压缩嵌入图片的分辨率。Anthropic 文档也提到,把 PDF 用提示词缓存保存下来,能改善对同一文档反复提问的性能与成本。
验证方法:用自己的文档测一遍
- 取一份有代表性的文档,用 Token 计数接口得出总 Token 与每页平均值。
- 分别按整篇放入、分块汇总两种方式各回答同一组 10 个问题,问题要覆盖开头、中段、结尾。
- 记录每种方式的总输入、总输出、耗时与答案是否准确,重点看中段内容有没有被遗漏。
- 选出在准确度可接受前提下成本更低的方式,并把窗口预留比例写进团队约定。
总结:预算先行,再选择处理方式
大文档任务的关键是先把预算算清:窗口容量、输出预留、系统提示与问题,剩下的才是文档能占用的空间。预算内且需要整体理解的,整篇放入并用缓存;超预算或需要逐章提取的,分块汇总;文档多、问题窄的,走检索。这类任务的 Token 用量峰值明显,可以先用一批真实文档跑一轮,看到实际用量之后,再对照 Tonbo AI 的按量充值与 Token 套餐,选择合适的额度方式。
延伸阅读