🤖 独享IP VPN:固定、静态、纯净IP如何影响AI开发与创作效率?
最后更新:2026年7月
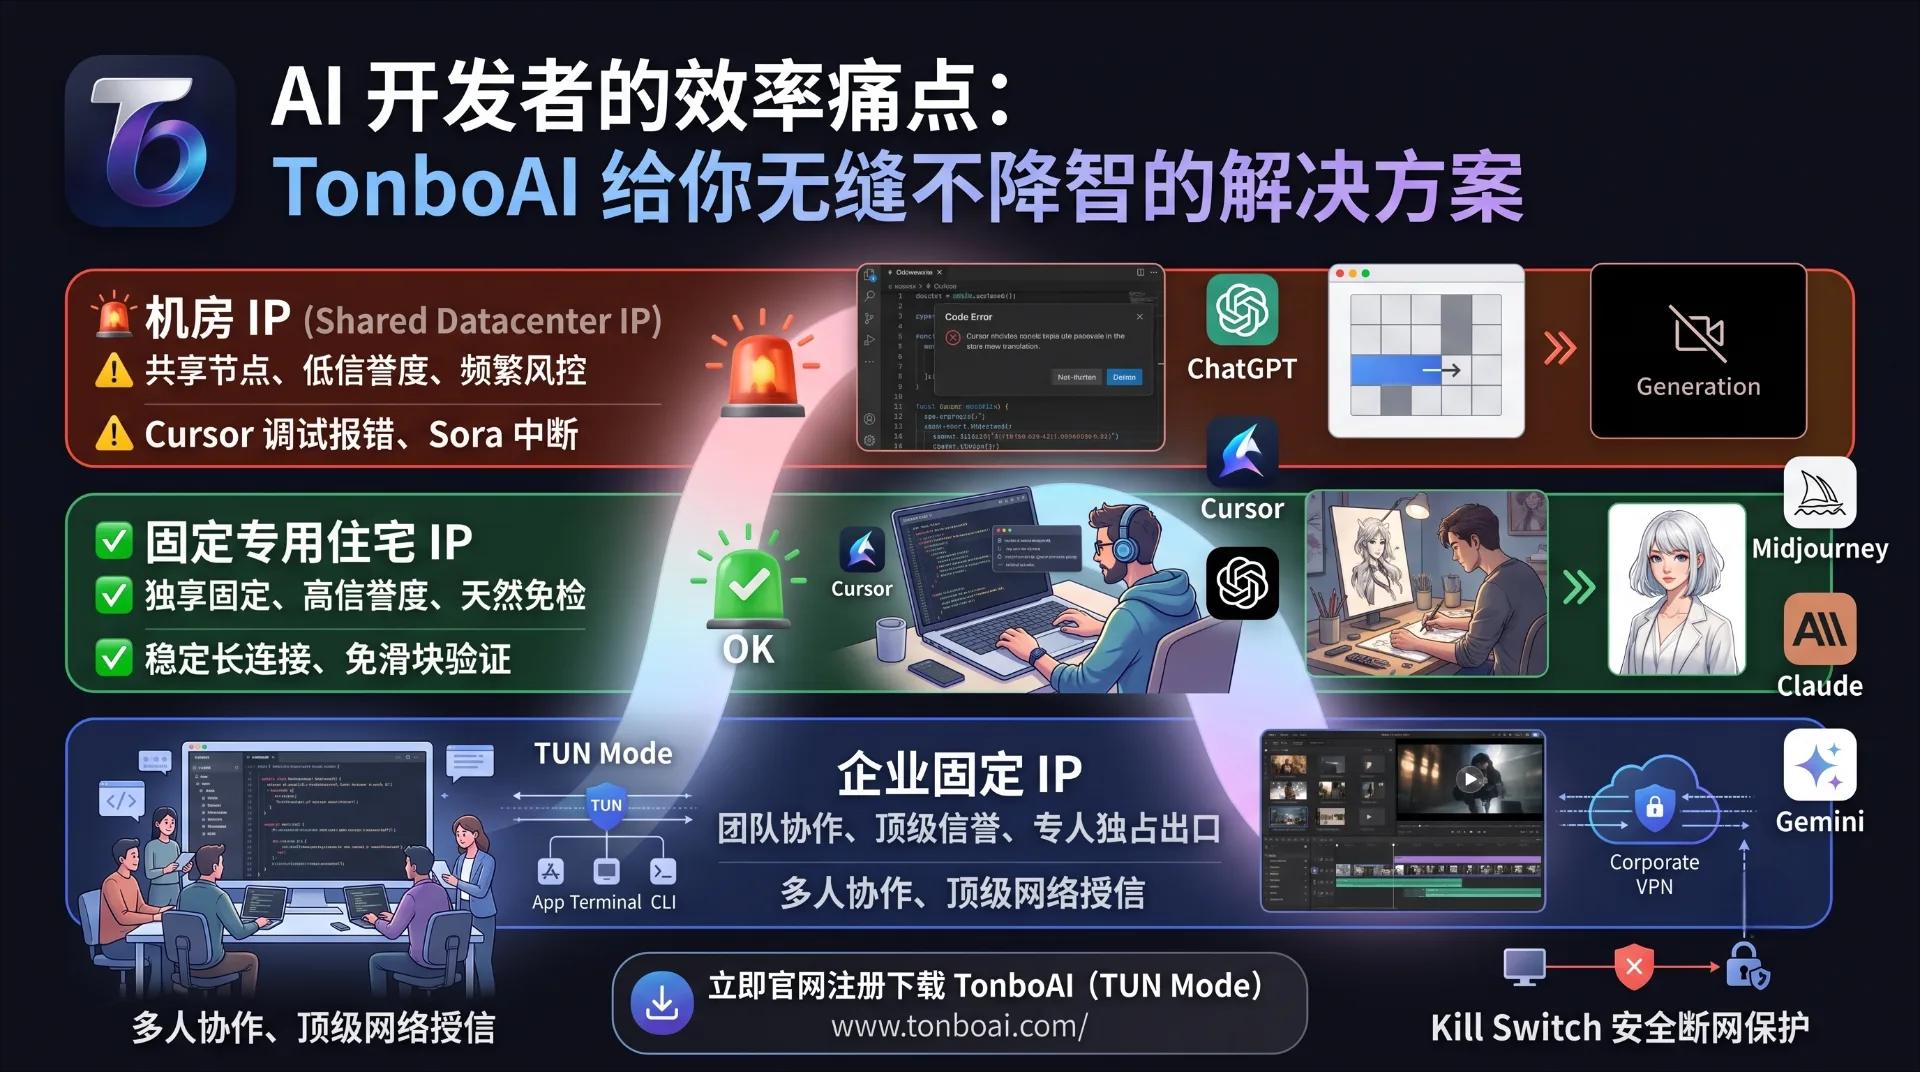
对于高频依赖 ChatGPT、Claude、Cursor、Midjourney 的开发者和数字创作者来说,最痛苦的不是订阅费,而是正在运行的 Agent 循环、长上下文 Debug 会话或视频渲染任务被网络异常中断。
网络质量不只是“延迟多少 ms”这么简单。AI 平台对反爬、自动化脚本和异常流量的监控极其严格。本文将为您拆解:独享 IP、固定 IP、静态 IP、纯净 IP 的底层技术逻辑,以及它们如何从根本上决定您的 AI 研发与创作效率。
📊 一眼看懂:不同 IP 质量对 AI 平台访问的授信差异
|
IP 类型 |
🏢 机房 IP(数据中心 IP) |
💎 纯净原生 IP |
🏡 住宅 IP(家庭宽带) |
|---|---|---|---|
|
信誉评级 |
🔴 低(极易被判定为 Bot) |
🟡 中(标准授信) |
🟢 极高(免检通行证) |
|
底层来源 |
大型公有云、托管机房、公有 IP 段 |
归属地一致、无典型 IDC(机房)特征的专线出口 |
海外本土电信运营商分配给真实住宅用户的家庭宽带 |
|
AI 风控表现 |
频繁弹滑块验证码、API 限制、降智(强制降级至 GPT-3.5 级别体验) |
正常顺畅访问,能应对大多数大模型平台的日常风控检测 |
全面模拟本地常驻人类,超大吞吐量生成、自动化 Agent 运行的首选 |
🛠️ 一、 方案选型:三档线路方案怎么选?
为了匹配不同强度的 AI 工作流,TonboAI 将网络资源合理划分为三个档位:
📊 线路方案参数对比
|
对比项 |
🌐 基础共享线路 |
🔒 固定专用 IP |
🏢 企业固定 IP |
|---|---|---|---|
|
IP 属性 |
多用户共享动态节点 |
单人独享 · 固定原生 IP |
团队独享 · 商用固定 IP 段 |
|
带宽分配 |
与他人共享(高吞吐时易拥堵) |
独享私有带宽(无干扰限制) |
独享企业带宽(支持多人高负载) |
|
TUN 支持 |
支持系统级接管 |
支持系统级接管 |
支持系统级接管 + 团队内部分流 |
|
最适场景 |
偶尔查资料、轻量级文字 AI 对话 |
独立开发者、数字游民、Cursor 重度依赖者 |
跨境 AI 创作工作室、技术开发团队、多人协作 |
1️⃣ 基础共享线路(性价比首选)
-
适用场景:日常轻度使用。偶尔用网页版 ChatGPT 提问、临时改改文案、查阅技术 API 文档。
-
特点:性价比极高,满足日常“轻量级、非连续性”的 AI 工具调用。
2️⃣ 固定专用 IP(专业创作者/独立开发者防线)
-
适用场景:重度依赖 Cursor/VSCode 协同编程,高频使用 Midjourney、Claude 跑超长上下文(Context Window)代码 Debug 任务的专业人士。
-
特点:由 TonboAI 在海外骨干网络为您单独开辟的 100% 独享 IP。在租期内,该 IP 归您一人专有,不仅彻底杜绝“因邻居违规导致 IP 连坐拉黑”,更能保证长时间会话(Session)的物理连续性,告别中途断连。
3️⃣ 企业固定 IP(跨境团队与工作室保障)
-
适用场景:多人协同的 AI 研发团队、批量生产 AI 营销视频的跨境工作室。
-
特点:提供独享的商用 IP 段资源,全员流量从统一、安全的出口出海。管理员可按需分配和回收席位,确保整个团队在稳定、无污染的网络身份下进行自动化协作。
🧭 二、 概念辨析:“固定 IP”与“静态 IP”是一码事吗?
答案是:是的,在网络工程中它们指的是同一个概念。
-
固定 IP / 静态 IP (Static IP):指在租期内,无论您的客户端断开、重连多少次,您分配到的出口 IP 地址始终保持不变。
-
动态 IP (Dynamic IP):指每次您重连、或因线路自动调度时,系统会为您指派一个 IP 池中随机变动的新 IP 出口。
为什么长时间的 AI 开发必须用固定/静态 IP? AI 平台的风控规则对 IP 的“突变和异地漂移”极为敏感。在开发一个长达数小时的 Cursor 编码会话或部署 Agent 自动化工作流时,如果中途网络重连导致 IP 变动,平台风控可能会强制中断当前的 WebSocket 握手或终止当前会话,导致生成的上下文丢失。固定静态 IP 确保了“会话开始到结束,网络身份自始至终高度一致”。
⚡ 三、 TUN 模式:系统层接管,攻克“终端不走代理”的痛点
对于开发者来说,最痛苦的莫过于:“浏览器里 ChatGPT 连得好好的,但在 VSCode 内置终端里跑 git clone 或 Python 脚本调用 OpenAI API 时,却依然报 Connection Timeout。”
这是因为传统的“系统代理/应用代理(HTTP/Socks5)”只在应用层生效,许多 IDE 和命令行(CLI)终端不遵守此规则。
-
⚡ 虚拟网卡接管(TUN Mode):TonboAI 原生内嵌的 TUN 模式,会在操作系统网络层虚拟出一个网络适配器。
-
🎯 真正全量分流:它直接捕获系统底层的 IP 包,让浏览器、IDE(Cursor/VSCode)、各种终端命令(npm, pip, docker)以及后台脚本的出口网络环境强行保持 100% 一致。从根本上避免了“部分应用走代理、部分应用裸奔导致连接报错”的混乱局面。
🔒 四、 稳定性、可靠性、安全性具体体现在哪里?
当您将 独享 IP、固定静态 IP 和 TUN 模式 组合在一起时,便构筑了高效、稳定的 AI 工作流:
-
🚀 极致稳定性: 独享专用带宽确保无第二人跟您抢占通道。在 Midjourney 批量出图等高吞吐量、高网络负载场景下,响应延迟始终保持最低水平。
-
🛡️ 坚实可靠性: 一致的出口环境配合 TUN 模式,保证了在进行复杂的 RAG 检索、Agent 自动化流水线(Agentic Workflow)运行时,整个链路不中断、无漂移。
-
🔐 高标准的安全性: 全局流量高强度加密。即便本地意外掉线,Kill Switch 防泄露机制也会瞬间阻断本地网络,防止您的真实本地 IP 暴露在开发生产日志中。
❓ FAQ 常见问题
Q1:固定专用 IP 和企业固定 IP 的本质区别是什么?
A:
固定专用 IP 面向个人开发者或创作者,单人独占一个纯净的固定住宅/原生 IP。
企业固定 IP 面向团队和工作室,提供独享的商用 IP 段,支持管理员统一配置、回收席位,满足多人高负载协同需求。
Q2:固定 IP 真的能减少 AI 平台的验证码(CAPTCHA)吗?
A:是的。AI 平台(如 Cloudflare 风控盾)是通过分析同一个 IP 的访问信誉度来决定是否拦截的。共享节点因为有很多人高频发送请求,常被判定为“爬虫/高危源头”从而要求频繁验证;而您个人独享的固定静态 IP 画像极其干净、干净度极高,风控系统会逐渐增加其授信分,免除无意义的二次验证。
Q3:我有必要为了偶尔聊聊天去买“固定专用 IP”吗?
A:没有必要。如果您只是偶尔用网页版写写日报、查查资料,TonboAI 的基础共享线路性价比更高、完全够用。我们建议当您的工作流中“长时间依赖 Cursor 连续编码”或“AI 创作直接产生商业收益”时,再平滑升级到固定/静态 IP,这才是更踏实的投资。
🏁 总结与行动指南
选 AI 开发专用的网络工具,从来不是只看“能不能连上”,而是要看这条线路在长时间、高负荷工作下的高一致性和抗风控表现。
TonboAI 提供了从轻量级到企业级团队协作的全谱系方案。按实际使用强度和业务痛点选档位,不花一分冤枉钱,让您的 AI 创作与开发效率全速飞奔。
👉 立即前往 TonboAI 官网下载体验:www.tonboai.com