结构化输出跨模型踩坑:同样叫 JSON 输出,约束强度并不一样
多模型工作流里,下游程序往往只认一种东西:能被解析、字段齐全的 JSON。但 OpenAI、Anthropic、Gemini 三家对“让模型输出 JSON”的实现并不等价:有的只保证语法合法,有的能按 Schema 约束解码,各家支持的 Schema 子集也不同,失败时的信号更是各写各的。如果团队直接把某一家的写法复制到所有模型上,通常要到线上才发现解析失败率上升。本文对照三家官方文档(核验日期 2026-10-01,细节请以各家页面为准),整理 Schema 子集差异、失败信号与一套可落地的适配与重试策略。
三种约束强度:JSON 模式、Schema 约束、提示词约定
JSON 模式只保证语法,不保证字段
OpenAI 官方文档明确区分了两件事:JSON 模式只确保输出是合法 JSON,而 Structured Outputs 才确保输出遵循你提供的 Schema。前者即便语法正确,也可能缺字段、多字段或类型不对。所以只要下游依赖固定字段,就应该优先用 Schema 约束,而不是把 JSON 模式当成“结构化输出”的同义词。
Schema 约束解码:三家的入口不同
OpenAI 用 response_format 里的 json_schema 并开启 strict;Anthropic 在请求里使用 output_config.format,类型为 json_schema;Gemini 则是 responseMimeType 设为 application/json,再配合 responseSchema。参数名、嵌套层级、是否要求 additionalProperties 为 false,都不一样,所以不建议在业务代码里直接拼各家的原始参数,而要在一个适配层里统一处理。
提示词约定:没有约束解码时的兜底
部分模型或旧版本不提供约束解码,只能靠提示词描述格式再由客户端校验。这种方式失败率最高,需要把“解析失败即重试”设计成默认路径,并且只在确认模型不支持 Schema 约束时才使用。
Schema 子集差异:同一份 Schema 换模型就报错
哪些约束容易被拒
OpenAI 文档提到,Structured Outputs 要求对象声明 additionalProperties: false,并且字段都要写进 required。Anthropic 文档列出的不支持项包括:递归 Schema、外部 $ref 地址、数值约束(minimum、maximum、multipleOf)、字符串长度约束(minLength、maxLength),以及 additionalProperties 取 false 以外的值。支持的则有基本类型、enum、const、anyOf、allOf、$ref 与 $defs,以及常见的字符串格式。
复杂度上限:编译失败是另一类错误
Anthropic 文档给出了复杂度限制:单次请求中严格模式的工具最多 20 个,所有 Schema 里的可选参数合计最多 24 个,联合类型参数合计最多 16 个,超限会返回“Schema is too complex for compilation”。这类错误不是模型输出问题,而是请求在编译阶段就被拒绝,应当在上线前用真实 Schema 做一次集成测试,而不是等到生产环境触发。
字段顺序和 Schema 本身也会占用 Token
Gemini 文档说明,响应 Schema 的大小会计入输入 Token 上限,并提供 propertyOrdering 来指定字段输出顺序,因为字段顺序会影响生成质量与一致性。Anthropic 文档则说明,必填字段按 Schema 顺序排在前面,可选字段排在后面;如果顺序对你有意义,建议把字段都设为必填,或在解析层不依赖顺序。把需要“先思考再下结论”的字段(例如 reasoning)排在结论字段之前,是几家都适用的经验做法,但具体效果请用自己的评测集验证。
| 维度 | OpenAI | Anthropic | Gemini |
|---|---|---|---|
| 约束入口 | response_format 的 json_schema,strict 模式 | output_config.format,type 为 json_schema | responseMimeType 加 responseSchema |
| 对象额外要求 | additionalProperties 为 false,字段写入 required | additionalProperties 只能为 false | 可用 propertyOrdering 指定字段顺序 |
| 文档提到的不支持项 | 部分关键字因性能或技术原因不可用 | 递归、外部 $ref、数值与字符串长度约束等 | 以官方 Schema 子集说明为准 |
| 拒答信号 | 响应里带 refusal 字段 | stop_reason 为 refusal,状态码仍是 200 | 以安全过滤与 finishReason 为准 |
| 首次延迟 | 首个新 Schema 请求有额外处理延迟 | 首次需编译语法,之后缓存约 24 小时 | Schema 计入输入 Token |
失败信号:200 状态码不等于拿到了合法 JSON
拒答:返回成功,但内容不是你要的结构
OpenAI 在模型因安全原因拒绝时,会在响应里放 refusal 字段,而不是符合 Schema 的内容。Anthropic 的拒答表现为 stop_reason 是 refusal,HTTP 状态码仍是 200,输出不会匹配 Schema。如果代码只判断状态码就直接 json.loads,这类请求会变成解析异常,而且很难与真正的格式错误区分开。
截断:max_tokens 太小也会产出残缺 JSON
OpenAI 文档指出,达到 max_output_tokens 上限或触发内容过滤,都会导致输出不完整;Anthropic 文档同样说明 stop_reason 为 max_tokens 时输出可能被截断、无法匹配 Schema,解决办法是调大 max_tokens。因此解析前应先检查结束原因,再决定是重试、调大上限还是降级。
枚举大小写与可选字段:安静出现的差异
Anthropic 文档提到,枚举值的字符串可能只在大小写上与 Schema 不同,例如首字母大小写,而响应仍是正常完成。建议枚举比较时忽略大小写,并避免定义只有大小写差别的枚举值。可选字段在不同模型上的“缺省”表现也不一致,缺省、null、空字符串三种写法要在解析层统一。
统一适配层与重试策略怎么落地
先写一份“最小公共子集”Schema
如果同一个任务要在多个模型间切换,最稳妥的做法是把 Schema 限制在三家都支持的范围内:不用递归、不用数值与长度约束、对象一律声明 additionalProperties 为 false、字段全部必填,用 null 的联合类型表示“无值”。范围类校验放到解析之后用代码完成,这样同一份 Schema 才能在回退链路上直接复用。
失败处理清单
- 先看结束原因:refusal、max_tokens、内容过滤分别走各自分支,不进入 JSON 解析。
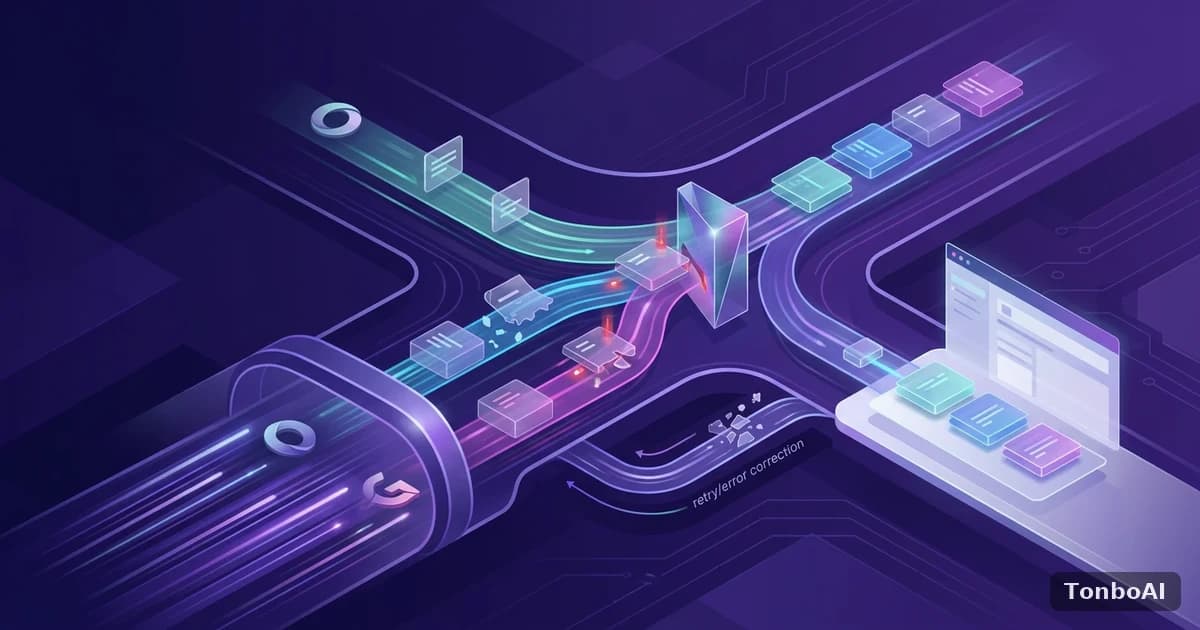
- 通过解析但校验失败:带上校验错误信息重试一次,把具体字段问题告诉模型,而不是原样重发。
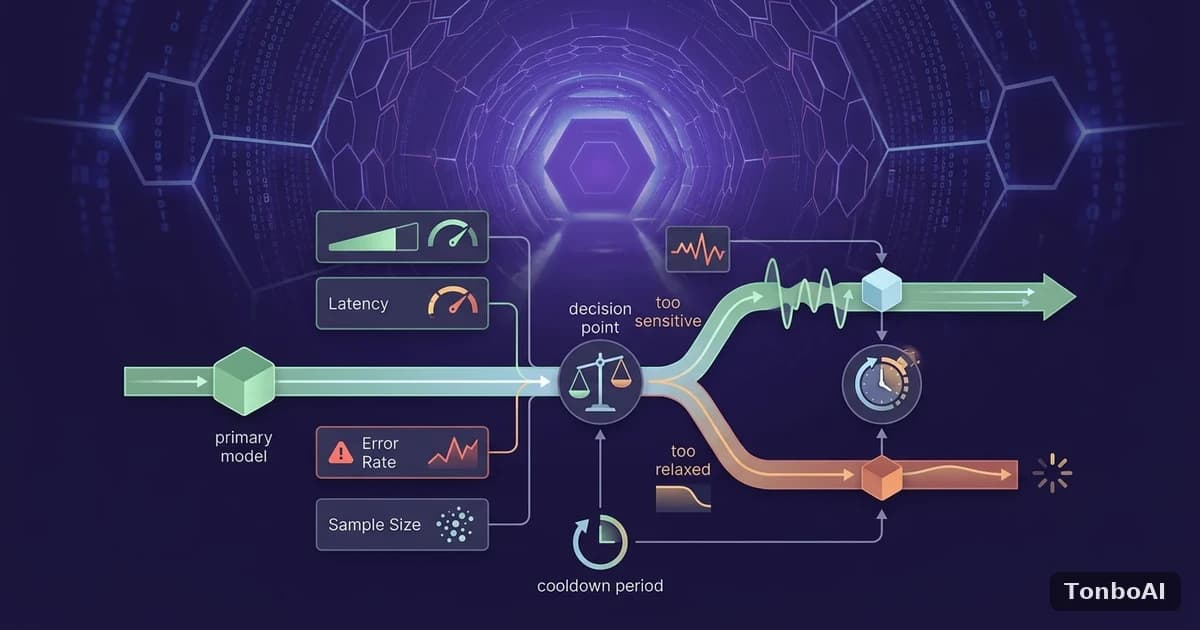
- 重试仍失败:切换到备用模型,必要时降级为更宽松的 Schema 或提示词约定模式。
- 仍失败:落入人工队列或返回明确的降级结果,并记录请求 ID、模型、Schema 版本与失败类型。
- 监控三个比率:拒答率、截断率、校验失败率,分模型统计,而不是只看总体解析成功率。
重试的预算要与限流和过载处理放在一起设计,不同错误类型的区分方法可以参考这篇API 报 429、529 或超时的三类错误区分,避免把格式错误当成网络问题一直重发。回退到备用模型的机制,则与多模型路由的自动切换原理一脉相承。
Schema 版本化:别让一次改字段拖垮缓存
Anthropic 文档说明,编译后的语法缓存约 24 小时,只有 Schema 结构或工具集变化才会使缓存失效,仅改名称或描述不会。这意味着频繁改字段会反复付出首次编译延迟。给每份 Schema 加版本号,在日志里记录版本,既便于定位问题,也方便在灰度时对比新旧 Schema 的失败率。
总结:把差异收进适配层,把失败当成常态
结构化输出的可靠性不取决于某一个模型,而取决于你有没有把 Schema 子集、拒答、截断、校验失败这四类问题分开处理。先收敛 Schema,再按结束原因分流,最后给每个失败类型配好重试与回退路径。如果你的团队同时调用多个模型,可以把适配层放在统一入口,再结合OpenAI 兼容的统一接口接入方式,在 Tonbo AI 的内置 AI Chat 面板里对同一份 Schema 做多模型对照测试,确认回退链路在真实调用下的表现。