为什么 Perplexity 这类 AI 搜索工具更容易“卡”
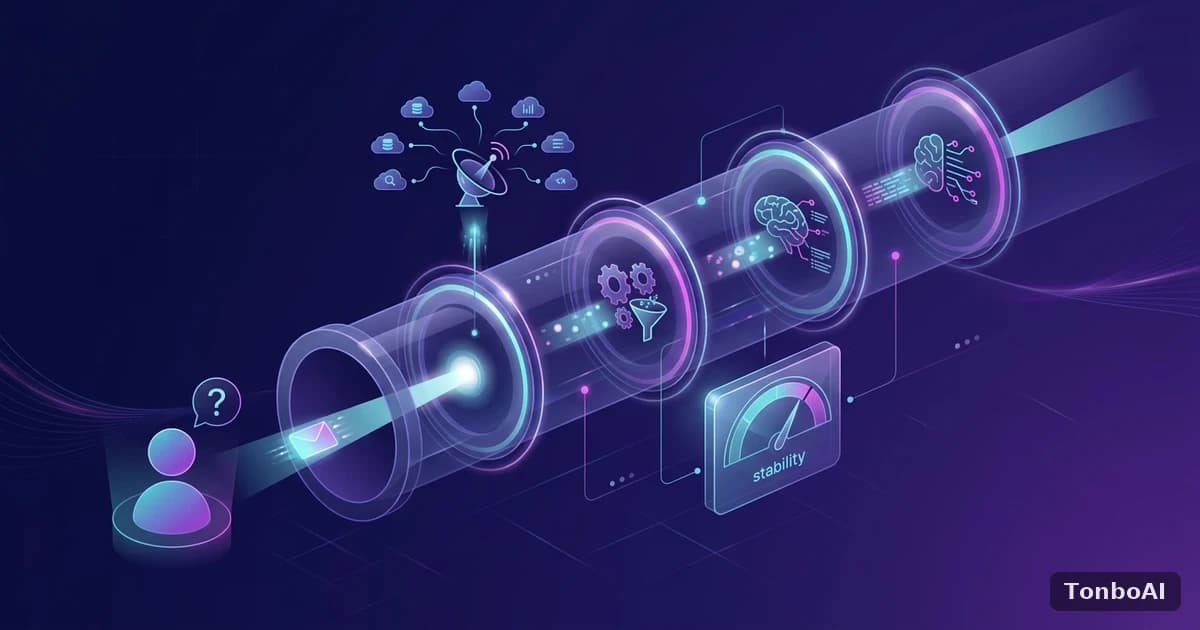
跟普通 AI 聊天工具比,Perplexity Pro 这类 AI 搜索工具的响应链路天生更长——它不是直接把问题丢给一个模型,而是先做实时网页检索,抓取多个信源,再把检索结果喂给模型做综合与引用标注。对普通聊天工具而言,网络只需要扇住一次请求-响应;但 AI 搜索工具的每一次提问,背后可能触发多次检索请求、多个信源抓取和一次模型综合调用,任何一环卡住,用户感知到的都是“整体变慢”。链路每多一环,受网络影响的节点就多一个,这也是为什么不少用户反馈“同样问 AI 问题,Perplexity 感觉更容易卡”的技术原因。
访问不稳的三种典型表现
表现一:检索阶段长时间无响应
提问后界面卡在“正在搜索”“正在阅读来源”这类状态,迟迟拿不到结果。这一步对应的是实时网页检索和信源抓取,如果某个上游网站本身响应慢,或者本地网络到检索服务的链路不稳定,都会拖慢这一环。
表现二:答案生成到一半中断
检索完成后进入模型综合生成阶段,这一步跟普通 AI 对话类似,如果传输链路不稳定,同样可能出现流式输出中断、需要重新生成的情况,而且因为前面已经花了时间做检索,中断重来的时间成本会比纯聊天工具更高。
表现三:引用来源加载失败或点击后打不开
Perplexity 的答案通常带有引用链接,点击查看原文来源时,如果目标网站本身在当地访问不稳定,即便 Perplexity 本身工作正常,用户体验上依然会觉得“打不开”“加载不出来”——这类问题的根源其实不在 Perplexity,而在被引用的原始网站。
实测数据
| 区域/来源 | 首字节响应(p50) | 说明 |
|---|---|---|
| 美国中部 | 约 83 毫秒 | 已知最快区域 |
| 亚太(东京) | 约 228 毫秒 | 已知区域中最慢 |
| 官方自评中位数 | 约 358 毫秒 | 官方 2025 年数据,p95 低于 800 毫秒 |
| 第三方独立基准测试均值 | 11 秒以上 | 与官方自评数据差异明显,反映真实使用场景更复杂 |
排查步骤
遇到 Perplexity 反应慢或加载不出来,按这个顺序排查更有效率:
- 先确认卡在哪个阶段——检索中、生成中,还是点击引用链接后——不同阶段对应的排查方向完全不同
- 如果是点击引用来源打不开,先判断是不是原始网站本身的问题,不一定是 Perplexity 或本地网络的问题
- 检索阶段长时间无响应,尝试更换提问方式或缩小检索范围,减少需要抓取的信源数量
- 如果是生成阶段反复中断,大概率是传输链路问题,优先排查本地网络连接的稳定性——像 Tonbo AI 这类提供 AI 安全隧道的连接方案,可以降低这类长链路请求中途掉线的概率
- 确认是否为区域性延迟问题——不同地理区域到检索服务的距离本身会带来几十到两百毫秒不等的基础延迟差异
常见问题
官方说延迟不到 1 秒,为什么我感觉经常要等好几秒甚至更久?
官方公布的延迟数据通常测的是核心检索接口本身,不包含具体提问的复杂度、需要抓取的信源数量、以及用户所在区域到服务节点的实际链路情况。第三方独立测试的结果往往比官方自评数字更长,这也提醒我们:评估一个工具的真实体验,不能只看官方公布的 benchmark。
Perplexity 打不开引用来源,该怎么办?
先确认是不是原始网站本身的问题——很多引用来源本身访问不稳定或需要登录,这跟 Perplexity 服务本身无关。如果确认是同一批网站反复打不开,再考虑是不是本地网络到这些站点的链路存在问题。
总结
Perplexity 这类 AI 搜索工具的响应链路比普通对话更长,卡顿未必是单一环节的问题。区分是检索慢、生成中断,还是引用来源本身访问不了,才能对症排查,而不是一律归咎于“网络不好”。