
通博AI 资讯中心
获取最新的网络安全资讯、AI 技术动态和产品使用教程。 关注 通博AI,让网络更安全、更智能。
最新资讯与资源
45 entries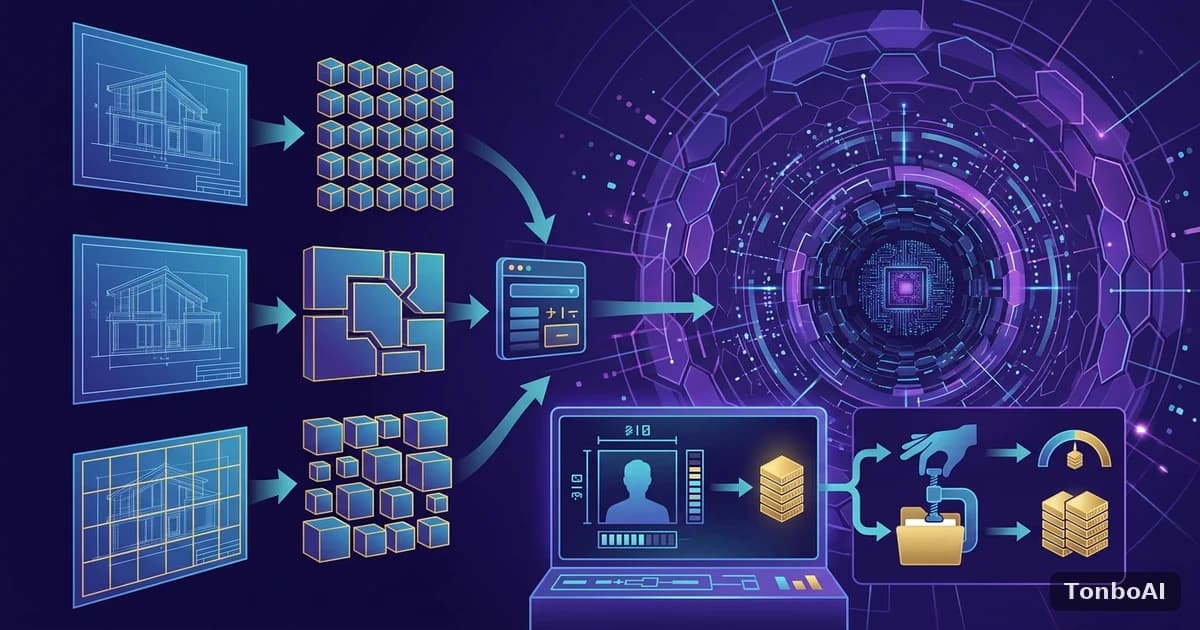
图片输入怎么计 Token:三家多模态 API 的计费方式与压缩实践
图片的 Token 成本不是看文件大小,而是看像素尺寸。本文对照三家官方文档讲清计算公式,并给出缩放、裁剪、压缩格式与文件引用的取舍原则。
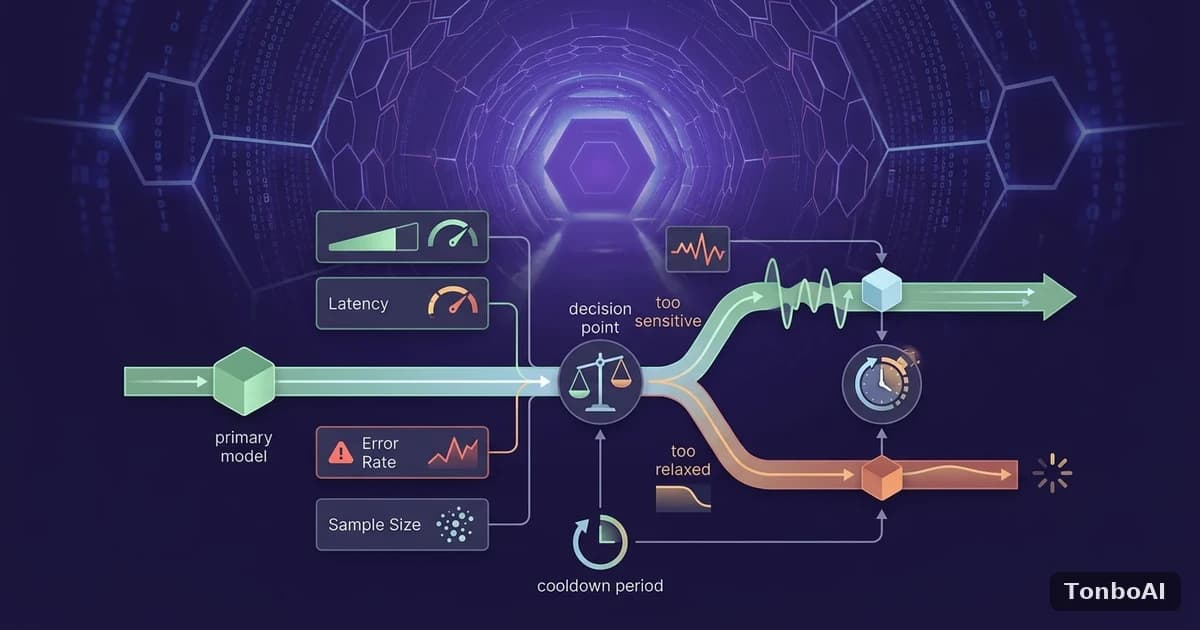
多模型回退阈值怎么设:P95 延迟、错误率、样本量与冷却时间
回退阈值设得太紧会频繁抖动,设得太松切换得太慢。本文参考熔断器默认参数与 SRE 的多窗口燃烧率告警,给出基线倍数、最小样本、冷却时间和错误类型分开统计的设置方法。
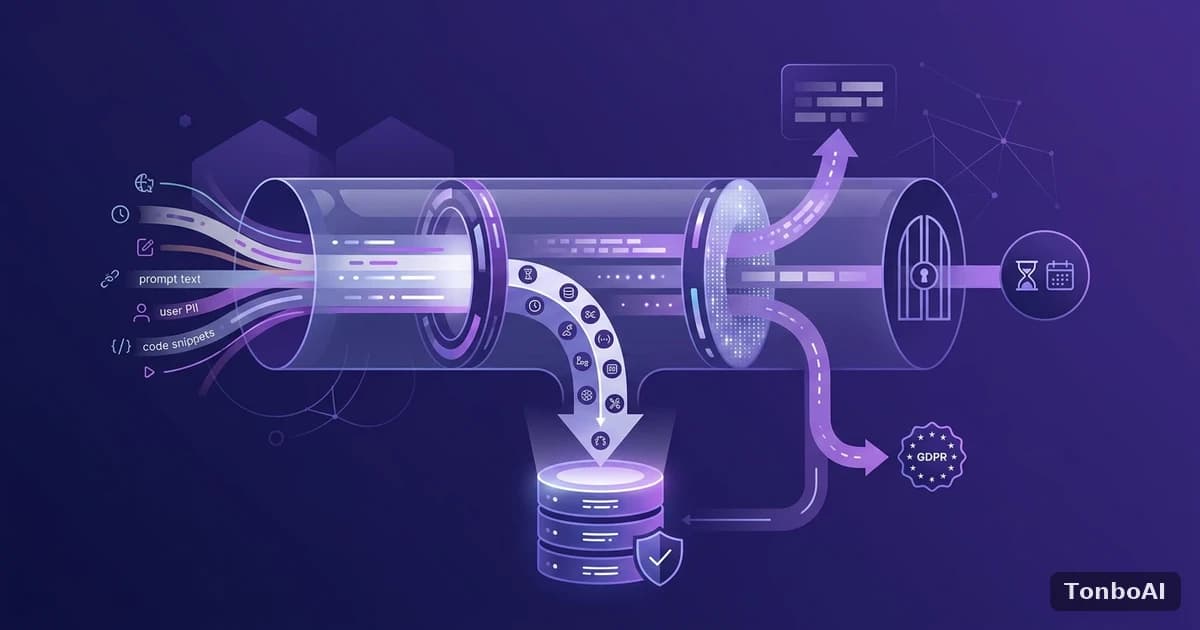
AI 调用日志与审计怎么设计:哪些字段必留、哪些应脱敏、留多久
调用日志既要能对账、排障和审计,又不能变成新的泄露点。本文对照官方文档和 GDPR 原则,把字段分成元数据、内容、聚合指标和禁止落盘四层,并给出保留期的设计思路。
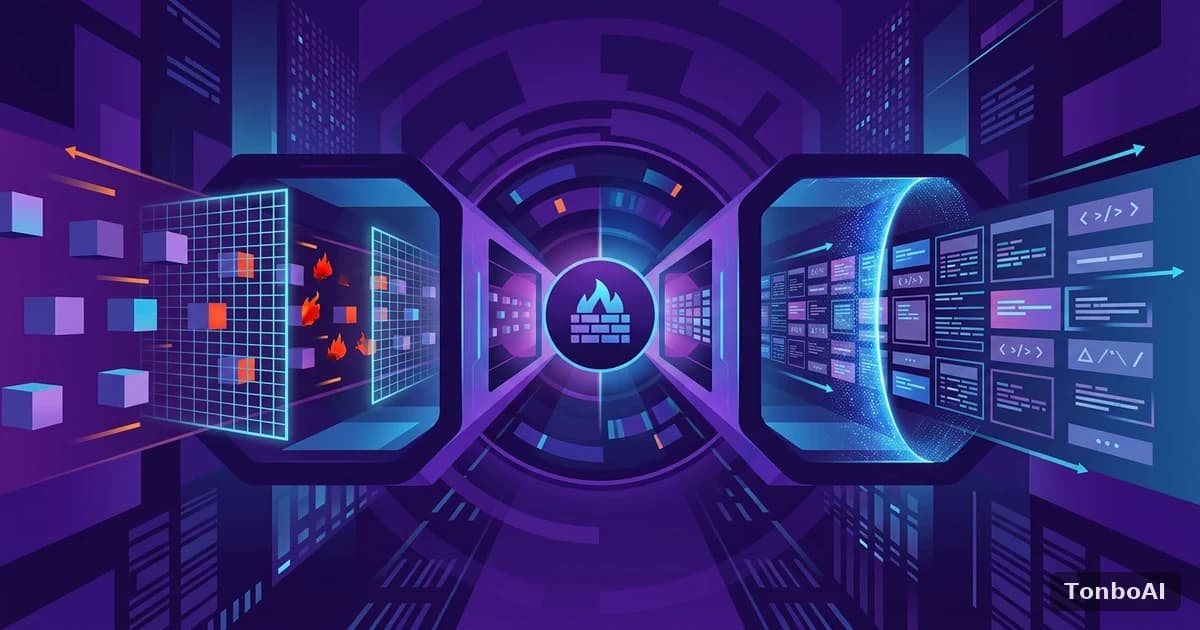
提示注入与数据脱敏不是一回事:企业 AI 网关该守哪几条边界
提示注入攻击的是指令入口,数据脱敏守的是信息出口。本文对照 OWASP 与 Presidio 文档,说明企业 AI 网关里两类控制各自能做什么、做不到什么,以及分层防护怎么排顺序。
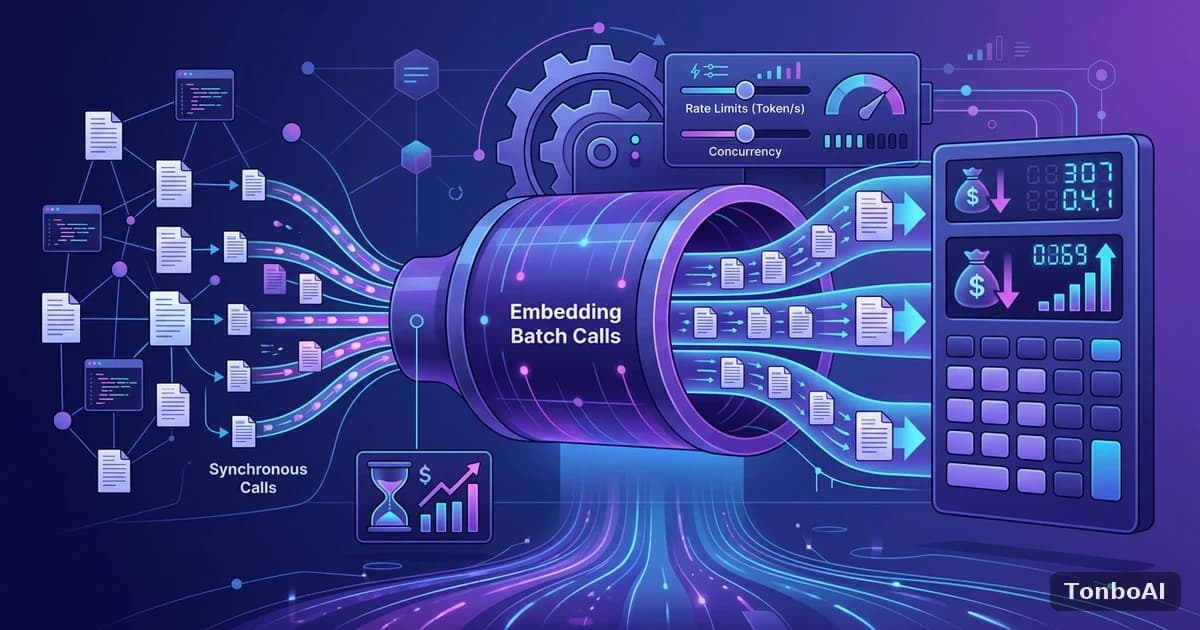
Embedding 批量调用怎么提速又省钱:限流、分批与 Batch 接口的账怎么算
Embedding 批量任务的瓶颈通常是输入 Token 与限流,而不是请求数。本文按官方文档换算百万文档的成本,并给出分批、限速、去重和失败续跑的做法。
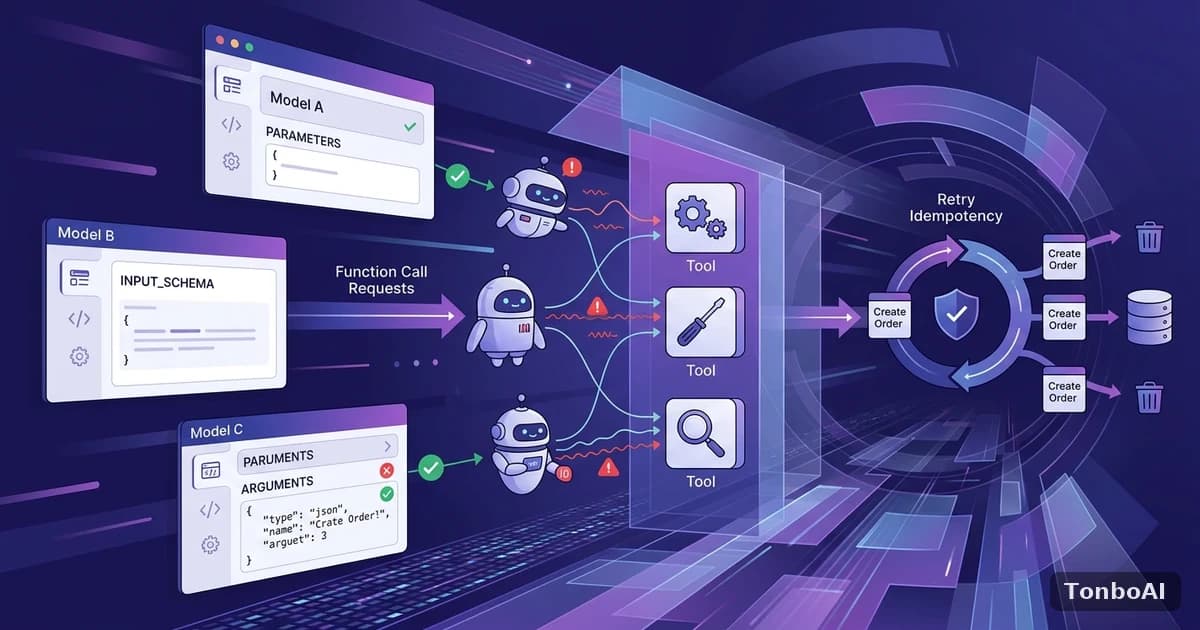
工具调用跨模型适配:参数返回、调用 ID 与重试幂等的三处差异
工具调用在不同模型上,定义字段、参数返回类型、强制调用方式和调用 ID 都有差异。本文对照官方文档给出统一适配写法,并说明工具重试为何要先做幂等。
结构化输出与 JSON 模式跨模型踩坑:Schema 子集差异与失败处理清单
结构化输出在不同模型间并不等价:Schema 支持子集、拒答信号、截断行为各有差异。本文对照官方文档,给出统一适配层与失败处理清单。
选多模型路由前该问的 8 个问题:AI 工作流负责人的采购清单
多模型路由的价值取决于故障切换、上下文兼容、缓存策略和账单透明度。本文面向 AI 工作流负责人,对照官方文档列出 8 个采购前要问的问题与打分方法。
团队 AI 预算治理:用量看板、告警阈值与部门分摊怎么设
团队用大模型之后账单容易变成糊涂账。本文对照官方文档,按看板维度、分层告警阈值、部门分摊三步,给出一套四周可落地的预算治理做法。
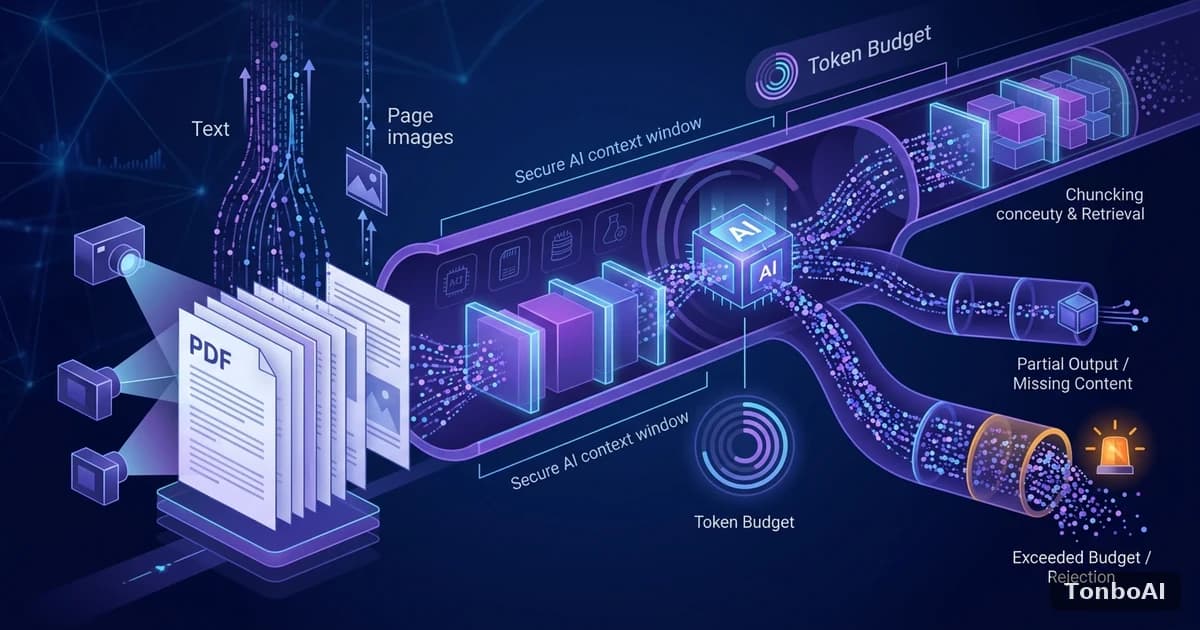
长文档与大 PDF 输入模型:上下文窗口、分块与 Token 预算实践
大 PDF 不能直接丢给模型。本文对照官方文档,讲清 PDF 如何计入 Token、页数与体积限制、预算怎么算,以及整篇放入、分块汇总、检索三种做法的适用场景。
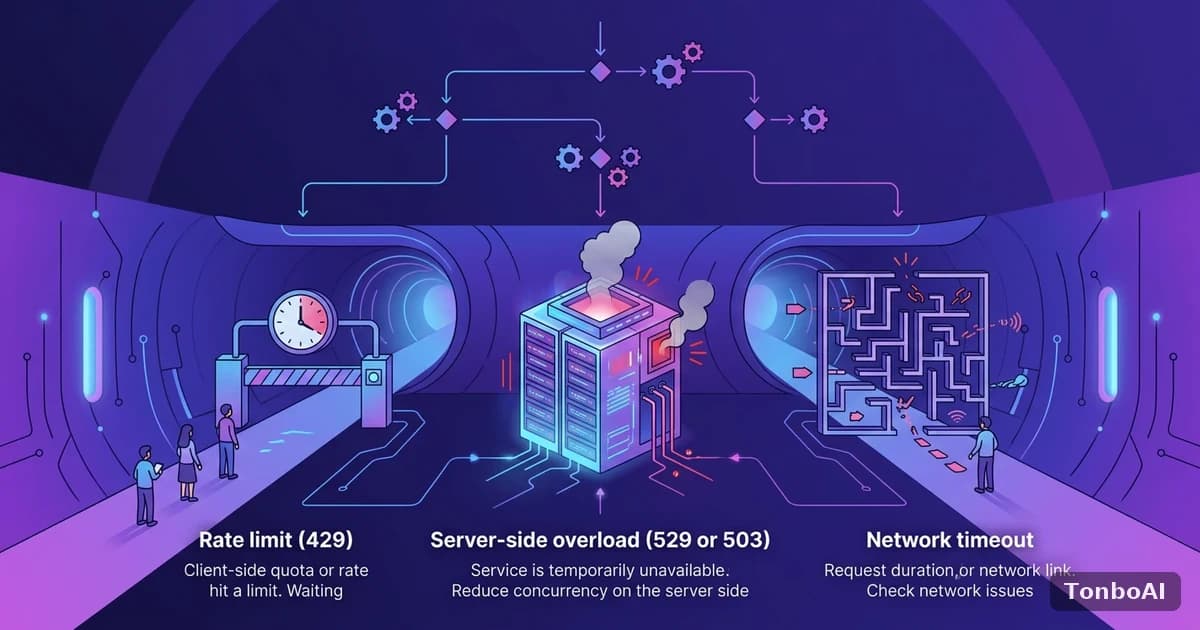
API 报 429、529 或超时:限流、过载、网络三类错误怎么区分与处理
429 多为限流或额度问题,529 与 503 是服务端过载,超时则与请求时长和链路有关。本文对照官方文档,给出三类错误的判断依据与重试规则。
流式输出中途断流:AI 回复到一半停住的原因与重连策略
AI 回复写到一半停住,可能是连接断了,也可能是输出上限或 error 事件。本文对照官方文档,按先判断、再定位、后重连的顺序,梳理 SSE 断流的排查方法与重连策略。