多模型回退阈值怎么设:切得太急会抖动,切得太慢等于没切
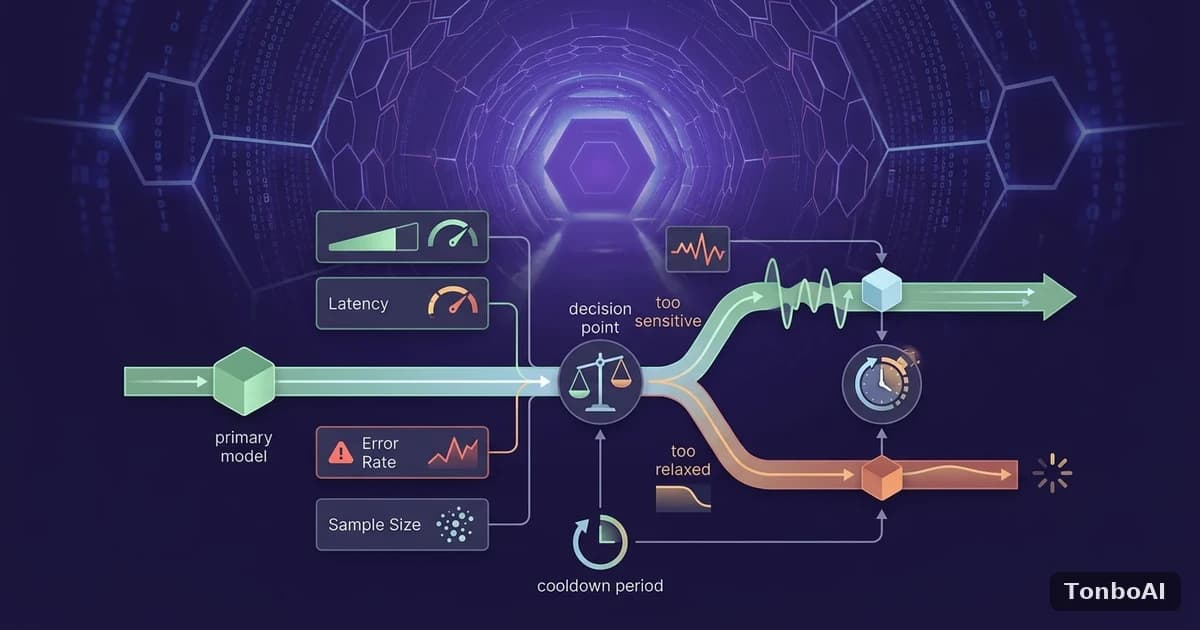
已经接入多个模型的团队,过一阵就会遇到一个具体的工程问题:主模型到底慢到什么程度、错到什么比例,才应该切到备用模型?阈值设得太紧,一次短暂抖动就全量切换,备用模型被突然流量压垮,缓存也跟着失效;设得太松,用户已经在等超时,系统还在“观察”。本文把这个问题当作阈值设计问题来拆,参考两份公开资料:Resilience4j 熔断器的默认参数,以及 Google SRE 工作手册里的多窗口多燃烧率告警(核验日期 2026-10-01)。文中的数字除已标明来源的之外,都是示例参数,需要用你自己的基线数据替换。
先定义“失败”:不是所有错误都应该触发回退
错误类型要分开统计
把所有非 200 都算一类“错误率”,是最常见的误区。限流类错误说明你自己的额度触顶,切到备用模型可以缓解,但应该同时触发限速而不是单纯切换;过载、服务端 5xx 和连接超时说明上游或链路有问题,适合作为回退触发条件;参数错误、认证失败则与模型没有关系,切换只会把同样的错误带到另一个模型。各类错误的区分方法可以对照API 报 429、529 或超时的三类错误区分,统计时把它们分成不同的分母和分子。
延迟要用“首字”和“总时长”两个口径
流式输出的体验主要看首字延迟,总时长则取决于输出长度。把两者混在一起统计 P95,会把“回答本来就长”误判为“模型变慢”。推理类模型尤其如此,进入思考阶段后首字本来就会延后,相关的等待特征可以参考推理模型响应慢是否正常的实测说明。建议按模型和任务类型分别统计首字延迟与总时长,阈值也分开设置。
流式中断算不算失败
回答输出到一半断掉,状态码已经是 200,很容易被“错误率”漏掉。比较稳妥的写法是把“未正常结束”也计入失败,重连策略见流式输出中途断流的原因与重连策略。
从熔断器默认值学到什么
最小样本量比阈值本身更关键
Resilience4j 的熔断器默认值值得参考:失败率阈值 50%,滑动窗口 100 次调用,至少 100 次调用之后才计算失败率,打开状态等待 60 秒后进入半开状态,半开状态允许 10 次试探调用,慢调用默认按 60 秒判定。最值得学的不是 50% 这个数,而是“样本不足时不计算”这个设计。一个低流量的内部工具,每分钟只有几次调用,连续失败两次就是 100% 错误率,如果没有最小样本量,就会频繁误切。“慢调用”默认 60 秒也不适合直接套用到对话场景,需要按任务类型调整。
半开试探:用少量流量检查主模型是否恢复
切到备用模型之后,不应该全量切回。熔断器的做法是等待一段时间后,只放少量试探请求过去,以它们的结果决定是否恢复。对模型路由来说,可以按比例逐步回切,例如先 5%,再 20%,再全量,每一步都用同样的指标确认。
从 SRE 告警模型学到什么
多窗口:慢窗口看趋势,快窗口看是否还在发生
Google SRE 工作手册推荐用多窗口、多燃烧率的方式告警:示例里,1 小时长窗口配 5 分钟短窗口、燃烧率 14.4,对应消耗 2% 的错误预算;6 小时配 30 分钟、燃烧率 6,对应 5%;3 天配 6 小时、燃烧率 1,对应 10%。短窗口通常取长窗口的十二分之一,作用是让告警只在错误仍在发生时触发,从而缩短恢复后的告警消除时间。文档也指出,简单的阈值告警在精确度与恢复时间上都较弱。
把这个思路用到回退决策
回退决策与告警并不完全相同,但思路可以借用:用“短窗口”确认问题正在发生,用“长窗口”确认不是偶发抖动,两个条件都满足才切换。这样一次几分钟的短时毛刺不会触发全量切换,而持续性的退化会在几分钟内被抓住。
| 信号 | 统计口径 | 示例触发思路 | 注意事项 |
|---|---|---|---|
| 过载与 5xx 错误率 | 按模型、按滑动窗口,分母为有效请求 | 短窗口和长窗口同时超过基线的若干倍 | 限流 429 单独统计,不混入 |
| 首字延迟 P95 | 按模型与任务类型分开 | 高于过去 7 天同时段基线的若干倍且持续一段时间 | 推理模型单独设置基线 |
| 总时长 P95 | 按输出长度分桶后统计 | 用于排查而非立即切换 | 输出越长越慢,需要归一化 |
| 流式非正常结束比例 | 状态码 200 但未收到结束标记 | 计入失败率 | 需客户端上报 |
| 样本量 | 窗口内有效请求数 | 低于最小样本不触发 | 低流量服务可改用合成探活请求 |
一套可以直接套用的设置步骤
用自己的基线,而不是网上的数字
- 采集过去 7 到 14 天的首字延迟与错误率,按模型和任务类型分开,得到基线的 P50、P95 与常态错误率。
- 确定最小样本量:参考熔断器默认的 100 次,再按自己的流量缩放,确保一个窗口内统计有意义。
- 设置双窗口条件:短窗口看当前是否超标,长窗口看是否持续,两者同时满足才切换。
- 设置冷却时间:切换后至少保持一段时间,再进入半开试探,避免来回抢切。
- 逐步回切:每一步都用同样的指标确认,失败则退回上一步。
- 审计:每次切换记录原因、触发指标、持续时间,每周复盘一次阈值是否合理。
回退有代价,阈值要把代价算进去
切到备用模型不是免费的:提示词缓存会按模型分开,切换后首次请求需要重新写入缓存,输出格式、工具调用与风格也可能不同,单价和额度也不一样。相关成本见提示词缓存的命中条件与命中率算法。所以阈值不应该追求“一抖就切”,而是“确认持续退化再切”,关键路径上的任务可以设得更敏感,批量、离线任务则优先等待与重试。
总结:先定义失败,再定基线,最后定阈值
回退阈值的设置顺序是:先把错误类型、首字延迟、流式中断的口径定义清楚,再用自己的基线数据设置倍数、最小样本和双窗口,最后设定冷却时间和逐步回切。如果你的团队需要在同一个入口管理多个模型的路由与回退,可以参考多模型路由自动切换的原理,并在 Tonbo AI 的内置 AI Chat 面板里用同一组提示词对比主、备模型的表现,再将阈值设置落到路由策略里。