图片输入的 Token 成本:看像素尺寸,不看文件大小
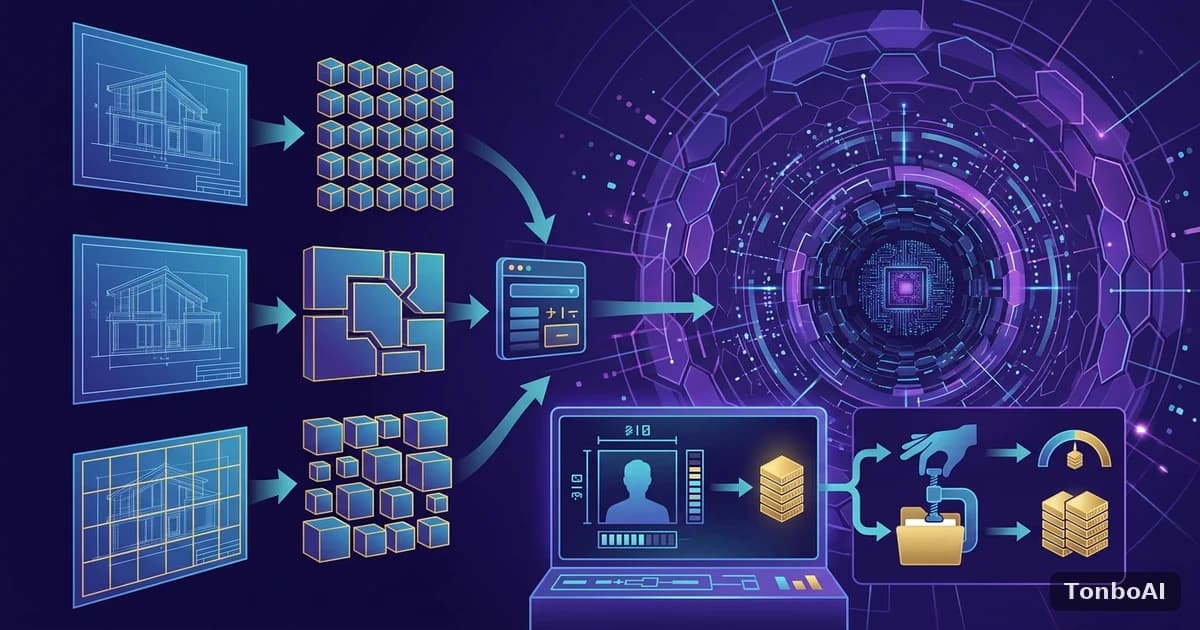
把截图、设计稿、票据或文档页面交给多模态模型处理时,团队的直觉往往是“图片越大、文件越大,就越贵”。实际并不是这样:三家主流 API 都是按像素尺寸切块,再按块数换算成 Token,与 JPEG 压得多狠关系不大。这意味着“把 5 MB 的图片压成 500 KB”并不会明显降低 Token 费用,只会减小请求体积;真正影响账单的,是图片的像素尺寸、模型的视觉精度档位,以及多轮对话里重复发送的图片数量。本文对照 OpenAI、Anthropic、Gemini 的官方文档(核验日期 2026-10-01,具体数值以官方页面为准),整理计算方式与工程上的压缩取舍。
三家的计算方式各不相同
Anthropic:28 像素一块,按块数计
Anthropic 的视觉文档说明,模型以 28×28 像素的块来观察图片,一张图片的成本是宽度除以 28 向上取整,乘以高度除以 28 向上取整。每个模型有最大的原生分辨率,超过就会被缩小:标准档的最长边上限为 1568 像素、最多 1568 个视觉 Token;较新的高分辨率档最长边上限 2576 像素、最多 4784 个视觉 Token。文档给出的例子很直观:1000×1000 像素的图片约 1296 个 Token;1920×1080 在标准档被缩到 1456×819,约 1560 个 Token,在高分辨率档不缩放,约 2691 个;3840×2160 在标准档约 1560 个,在高分辨率档约 4784 个。文档也提示,高分辨率档的视觉 Token 可能是标准档的约三倍,如果不需要额外的细节,发送前先缩小。
OpenAI:新模型按 32 像素切块,老模型按 512 像素瓦片
OpenAI 的图片输入文档把模型分成两类。较新的模型采用基于切块的计算,每块 32×32 像素,块数等于宽除以 32 与高除以 32 分别向上取整后相乘,超过模型的块数预算时按比例缩小,且部分模型会再乘以一个倍率系数;较早的模型则采用“基础 Token 加各瓦片 Token”的方式,高精度时先缩放到不超过 2048×2048,再按 512 像素的方块计数。detail 参数有 low、high、original 和 auto 几种,low 适合粗略理解,图片被限制在 512×512 范围内。文档还说明支持 PNG、JPEG、WEBP 与非动画 GIF,单次请求体积和图片数量都有上限。由于不同模型的系数与预算不同,实际估算时要查对应模型的条目。
Gemini:小图固定值,大图按 768 像素瓦片
Gemini 文档给出的基础规则是:两个边都不超过 384 像素的图片计 258 个 Token;更大的图片切成 768×768 的瓦片,每块 258 个 Token。较新的模型还提供 media_resolution 参数,用来控制每张图片或每个视频帧最多分配多少 Token,在细节、延迟与成本之间取舍。内联图片数据的请求总量限制为 20 MB,超过或需要复用时建议用 Files API。
| 维度 | Anthropic | OpenAI | Gemini |
|---|---|---|---|
| 切块大小 | 28×28 像素 | 新模型 32×32,老模型 512 瓦片 | 小图固定,大图 768 瓦片 |
| 单图 Token 上限 | 标准档 1568,高分辨率档 4784 | 按模型的块数预算 | 按瓦片数与 media_resolution |
| 精度控制 | 发送前自行缩放 | detail 参数 | media_resolution 参数 |
| 文件引用 | Files API 的 file_id | 支持文件与 URL 输入 | Files API,内联超 20 MB 需改用 |
| 单请求图片数 | 最多 600,200k 上下文模型为 100 | 文档标注最多 1500 | 文档标注最多 3600 |
压缩实践:哪些真省钱,哪些只是把字压糊
先按目标模型的上限预缩放
以 Anthropic 的标准档为例,3840×2160 的图片会被服务端缩到长边 1456 左右,计费与 1920×1080 几乎一样,多发的像素只是白白占用带宽和延迟。所以客户端或网关先按模型上限缩放,比上传原图更合理;反过来,如果用了高分辨率档,原图不缩放的成本可能高出很多,需要判断任务是否真的需要那么高的细节。
文字类图片用裁剪代替缩小
截图里真正需要读的往往只是一块区域。把整张图缩小会让小字变得难读,而把不相关的区域裁掉,既降低 Token,又保留清晰度。Anthropic 文档也提醒,关键文字要保持可读,避免为了放大文字而裁掉关键上下文。
有损压缩的分寸
文档明确指出,用 JPEG 或有损 WebP 压缩可以减小请求体积、降低延迟,但会引入伪影,尤其多次压缩叠加后文字可能难以读取。建议的做法是把“压缩后的真实图片”拿来抽检,而不是只看压缩参数;对票据、表格、代码截图这类以文字为主的图片,优先用无损格式或较高的质量参数。
多轮对话里的重复发送
多轮对话与智能体流程里,每一轮请求都会把完整历史再发一遍。如果图片是 base64 内联的,每一轮都会带上完整的图片字节,请求体积和延迟会随轮数增长。Anthropic 文档建议把图片先上传到 Files API,再用 file_id 引用,这样请求体积不会随图片数量累积。需要注意的是,这只减少传输体积,图片对应的视觉 Token 仍然会随历史累计,上下文预算的设计思路可以参考长文档与大 PDF 输入的上下文与 Token 预算。
一份可执行的图片输入规范
- 按目标模型查明切块公式与 Token 上限,写进网关配置,而不是散落在各业务代码里。
- 发送前按上限缩放,超过上限的像素不会带来额外理解力。
- 文字为主的图片先裁剪再缩小,压缩格式用高质量参数,并抽检真实效果。
- 多轮会话用文件引用代替内联图片,并在历史里只保留需要的图片。
- 在用量看板里把“图片 Token”与文本 Token 分开统计,异常时能快速定位。
图片 Token 突然抬升,往往是超支的隐藏原因之一,排查思路可以对照Token 用量突然超支怎么办。跨模型比较单价时,可以查看2026 主流大模型 API 定价比较,再结合图片的切块公式换算成实际费用。
总结:算清切块,再决定压缩
图片输入的成本主要由像素尺寸和精度档位决定,文件大小只影响传输。算清三家的切块公式,再按任务选择缩放、裁剪、压缩格式与文件引用,比追求“文件越小越好”更有效。如果你的工作流需要在多个多模态模型之间切换,可以在 Tonbo AI 的内置 AI Chat 面板里用同一组截图对比不同模型的识别效果,再结合按量充值的 Token 用量记录,确定哪类图片走哪个模型和哪一档精度。