团队 AI 预算治理:让用量看得见、拦得住、分得清
团队开始大量使用大模型之后,账单很快会变成一笔说不清去向的费用:谁在用、用在哪、超了怎么办,都没有答案。团队 AI 预算治理要解决的就是三件事:用量看板让消耗看得见,告警阈值让超支拦得住,部门分摊让成本分得清。本文对照 Anthropic 与 OpenAI 的官方用量与限额文档(核验日期 2026-09-20),给出一套可以直接照着搭的做法,其中阈值与分摊比例都是建议起点,需要按你团队的历史数据调整。
第一步:用量看板要看哪些维度
先确认数据从哪里来
Anthropic 提供 Usage 与 Cost 两个管理接口,可以按时间桶、模型、工作区、API Key 等维度查询用量,成本接口以美元返回,并支持按工作区分组用于内部结算。这些接口需要管理员级别的密钥,工作区级别的普通密钥无法使用。OpenAI 的限额与花费上限则可以在组织和项目两个层级配置,响应头里也带有项目范围的 Token 限额信息。看板的数据源应优先选官方接口,而不是自己在日志里累加,因为官方数据能与最终账单对得上。
看板至少包含的六个维度
| 维度 | 回答的问题 | 数据来源示例 |
|---|---|---|
| 按团队或项目 | 哪个部门在花钱 | 工作区、项目划分 |
| 按模型 | 贵的模型是否被用在不需要的任务上 | 用量接口的模型分组 |
| 按 API Key 或应用 | 哪个应用突然放量 | Key 级别用量 |
| 输入、缓存、输出拆分 | 缓存是否生效,输出是否失控 | 未缓存输入、缓存读写、输出各自的 Token 数 |
| 思考占比 | 推理模型的隐性输出有多大 | 响应里的用量明细字段 |
| 日环比与月累计 | 是否偏离预算曲线 | 按日聚合后自行计算 |
数据延迟与口径细节
Anthropic 文档说明,用量与成本数据通常在请求完成后 5 分钟内出现,偶尔更久,持续轮询建议每分钟一次,仪表盘需要频繁刷新时应缓存结果。另外有几处口径要提前约定:归属默认工作区的用量,其工作区标识为空值;控制台演练场里的调用不关联 API Key,所以按 Key 分组时也是空值;优先级层级的费用不在成本接口里,需要从用量接口按服务层级查看。
第二步:告警阈值怎么设
用分层阈值代替单一红线
只设一个上限,触发时往往已经晚了。下表是常见的分层做法,具体数值是建议的起点,不是任何官方标准,请按历史数据调整。
| 层级 | 触发条件示例 | 动作 |
|---|---|---|
| 提示 | 月预算的 50% 与 80% | 通知团队负责人,附上用量排名前三的应用 |
| 预警 | 当日用量比过去 7 日均值高出一定比例 | 通知值班人,检查是否有失控的循环或批量任务 |
| 限制 | 月预算的 100% | 对非关键应用降级到更便宜的模型或暂停 |
| 熔断 | 单个 Key 短时间内用量异常陀增 | 自动停用该 Key 并通知负责人 |
官方上限只能当最后一道兺底
Anthropic 各层级有每月花费上限,触达后 API 用量会暂停到下月初,此时接口返回 429 且没有 retry-after,重试无效;自己设置的花费上限触达时则返回 400。工作区还可以单独设置花费与速率限制,防止某个工作区把整个组织的额度用完,默认工作区不能设置限制。OpenAI 同样支持在组织与项目层级配置花费上限。这些上限触达就意味着业务已经中断,所以它们应当排在自建告警之后,而不是取代告警。
先记录两周,再定阈值
阈值不是万能数字。建议先让看板运行一到两周,只记录、不告警,看清每个团队用量的日常波动范围之后,再把预警阈值设在“正常波动之上、异常之下”的位置。新上线的应用没有历史数据时,先给一个宽松的临时上限,并在两周后回看。
第三步:部门分摊怎么做
先选口径:展示还是结算
分摊分为两种做法。展示(showback)只告诉各团队花了多少,不要求承担;结算(chargeback)则把成本计入部门预算,需要在下次规划时说明理由。刚起步的团队适合先做展示,让数字稳定、口径被认可,再过渡到结算。
用一个假设数字演示分摊公式
下面的数字为演示而假设,不是任何团队的真实数据:月总花费 10,000 个单位,其中部门甲直接归属 4,000、部门乙 3,000、部门丙 1,000,另有 2,000 是共享成本,比如公共系统提示、共用工具和平台服务。共享成本按各部门直接用量的比例分摊,直接用量合计 8,000。
- 部门甲:4,000 加 2,000 × 4/8,合计 5,000。
- 部门乙:3,000 加 2,000 × 3/8,合计 3,750。
- 部门丙:1,000 加 2,000 × 1/8,合计 1,250。
- 三者相加为 10,000,与总账单一致,这是检查分摊是否漏算的最简单方法。
分摊口径要写成规则
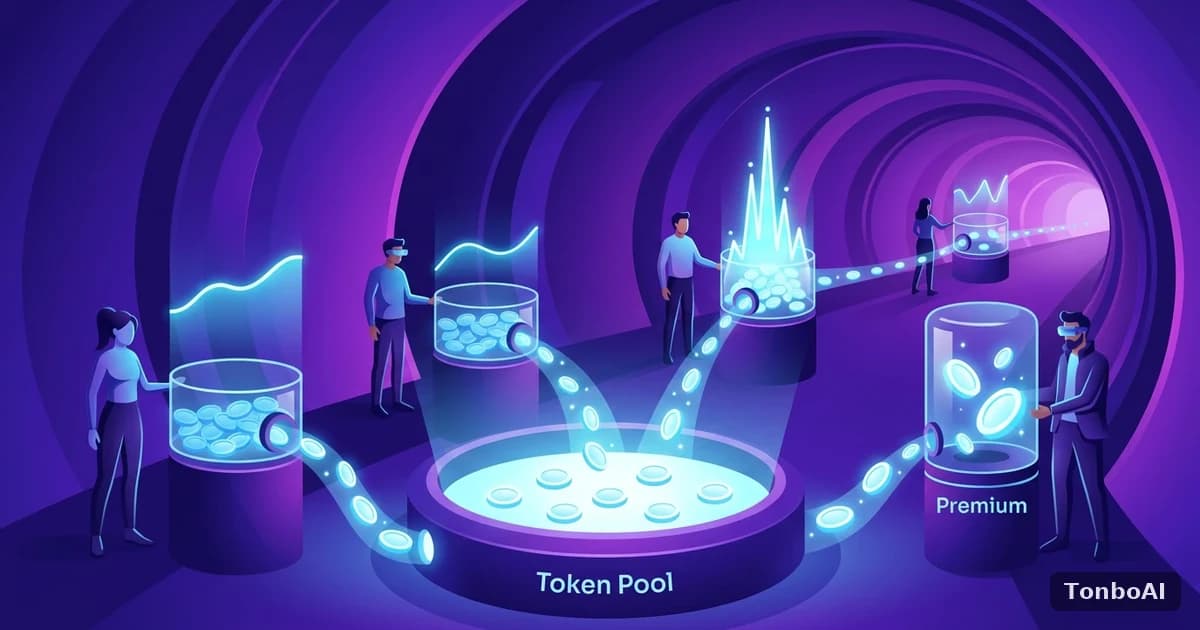
口径不写清,每个月都会重新争论一次。建议明确三条:直接归属按工作区或项目划分;无法归属的调用,例如空值工作区,先进入待认领池并限期认领;共享成本采用固定的比例规则,季度内不改。共享额度的用法,与 Tonbo AI 团队 Token 池这类多人共用额度的场景是相通的:先定额度归属与告警,再谈使用体验。
落地清单:四周搭起最小可用的治理
- 第一周:按团队或项目拆分工作区与密钥,停止多人共用同一个 Key。
- 第二周:接入官方用量与成本接口,搭出包含六个维度的看板,先只看不报警。
- 第三周:根据两周的历史数据设置分层阈值,把提示级别的通知发到团队群,把熔断级别的动作写进运维手册。
- 第四周:出第一份展示报表,包含直接归属、共享分摊和待认领三部分,并让各团队确认口径。
之后每个月复盘一次:哪些应用超预算、缓存命中率与思考占比是否变化、有没有可以降级到更便宜模型的任务。
总结:先看清,再限额,最后分摊
预算治理的顺序不能反:没有看板就设不出合理阈值,没有阈值就谈不上熔断,没有明确口径就无法分摊。把官方接口的数据、分层告警和写成规则的分摊口径三件事做完,团队 AI 用量就从一笔糊涂账变成可以复盘的成本项。如果你的团队正在评估共享额度的用法,可以先按本文的方法跑两周,拿到各部门的真实用量之后,再对照 Tonbo AI 的团队 Token 池与 Token 套餐做选择。
延伸阅读