API 报 429、529 或超时:先分清限流、过载、网络三类错误
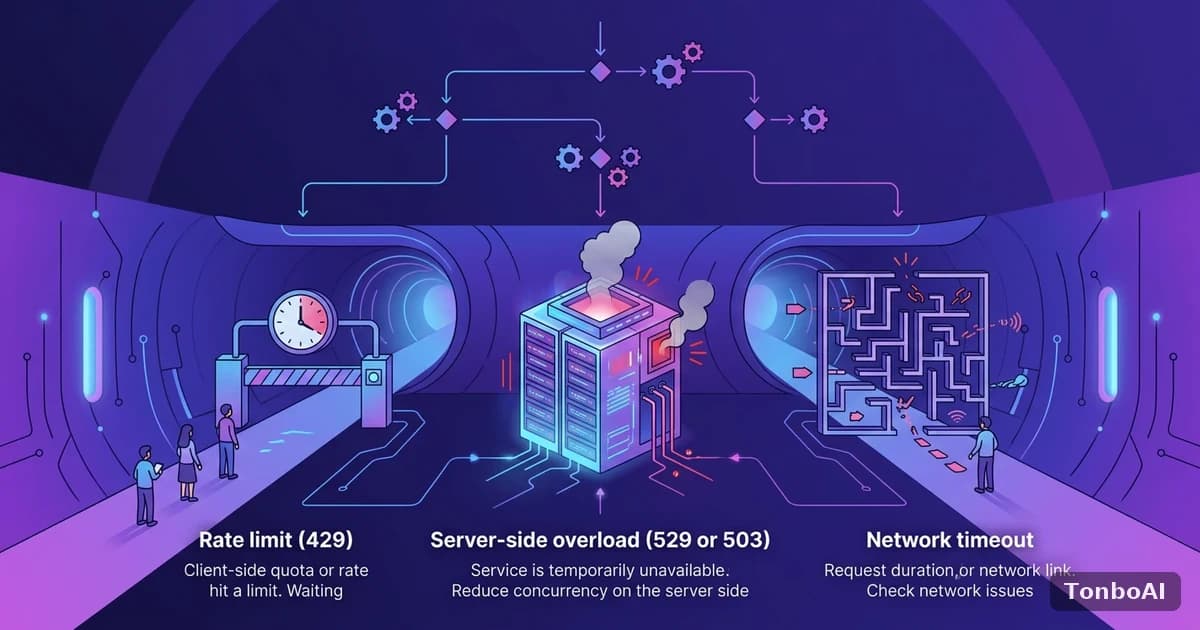
调用大模型 API 时,429、529 overloaded 和超时看上去都是“请求失败”,但它们的责任方不同,处理方式也不同:429 通常说明你这一侧的配额或速率触顶,529 与 503 说明服务端暂时过载,超时则多半与请求时长和链路有关。把三类错误混在一起用同一套重试逻辑,结果往往是该等的没等、该停的没停。本文对照 Anthropic 与 OpenAI 的官方错误文档(核验日期 2026-09-20),给出区分方法与对应的处理策略。
三类错误怎么区分
下表按“谁的问题、能不能重试、该怎么处理”三个维度整理,状态码与错误类型名来自两家官方文档。
| 类别 | 典型信号 | 根因归属 | 是否重试 | 首选处理 |
|---|---|---|---|---|
| 限流 | HTTP 429,Anthropic 为 rate_limit_error,通常带 retry-after 头 | 你的账户速率或用量触顶 | 按 retry-after 等待后可重试 | 降并发、客户端限速、分散流量 |
| 额度耗尽 | 同样是 429,但没有 retry-after;OpenAI 有余额耗尽、花费上限一类的专门代码 | 账户额度或花费上限 | 重试无效 | 充值、提高上限或等待额度恢复 |
| 过载 | Anthropic 为 529 overloaded_error,OpenAI 为 503 server_is_overloaded | 服务端暂时满载,与你的用量无关 | 可以,但要慢且有上限 | 指数退避、降压、切换备用模型 |
| 超时 | Anthropic 为 504 timeout_error,或客户端读超时、连接被重置 | 请求过长或链路不稳 | 视情况 | 改用流式、拆分任务、检查链路 |
限流类:429 到底该等还是该停
速率限制:读 retry-after,不要立刻重发
Anthropic 的速率限制以每分钟请求数、每分钟输入 Token 数、每分钟输出 Token 数三个维度计量,超出任意一个都会得到 429,并带有说明哪一项超限的信息以及 retry-after 头,指示需要等待的秒数,更早的重试会继续失败。它采用令牌桶算法,容量是持续回补的,而不是在固定时刻整体重置。文档还提醒,短时间内的突发可能触发限制:每分钟 60 次的额度,可能被按每秒 1 次来执行。响应头里还带有 anthropic-ratelimit 系列的剩余量与重置时间,可以用来在触顶之前主动降速。
加速限制:用量陀增也会被 429
两家文档都提到了同一类情形:即使没有超过额度,流量突然陀增也会被限制。Anthropic 称之为加速限制,建议逐步放量、保持稳定的用量模式;OpenAI 文档提到,在流量达到较高量级之后,请求速率上升过快也会返回 429,并给出了逐步增长的示例幅度,具体数值请以官方页面为准。上线新功能或批量任务前,先做爬坡式放量,比事后加重试更有效。
额度耗尽:这种 429 重试没有意义
Anthropic 文档说明,账户触达所在层级的每月花费上限时,同样返回 429 且错误类型仍是 rate_limit_error,但没有 retry-after 头,错误详情里的 error_code 为 enforced_spend_limit_reached,SDK 的自动重试也会一直失败,直到额度恢复或上限被提高。自己设置的花费上限则返回 400。OpenAI 也把“余额耗尽”“组织或项目花费上限”与普通速率限制区分为不同的 429 情形。处理这类错误的正确动作是告警和人工介入,而不是重试。
过载类:529 与 503 别当成 429 来修
为什么过载不是你的错
Anthropic 文档说明,529 表示 API 暂时过载,可能在高峰期影响所有用户;OpenAI 的 503 对应“请求的模型暂时过载”。它们与你的速率额度无关,所以“把并发降到很低”只能减轻自己的压力,并不能让服务端更快恢复。
过载时的处理顺序
- 先重试,采用指数退避加随机抖动,并设置最大次数与最长等待时间。
- OpenAI 文档建议:有 Retry-After 头时以它为准,没有时使用带抖动的指数退避。
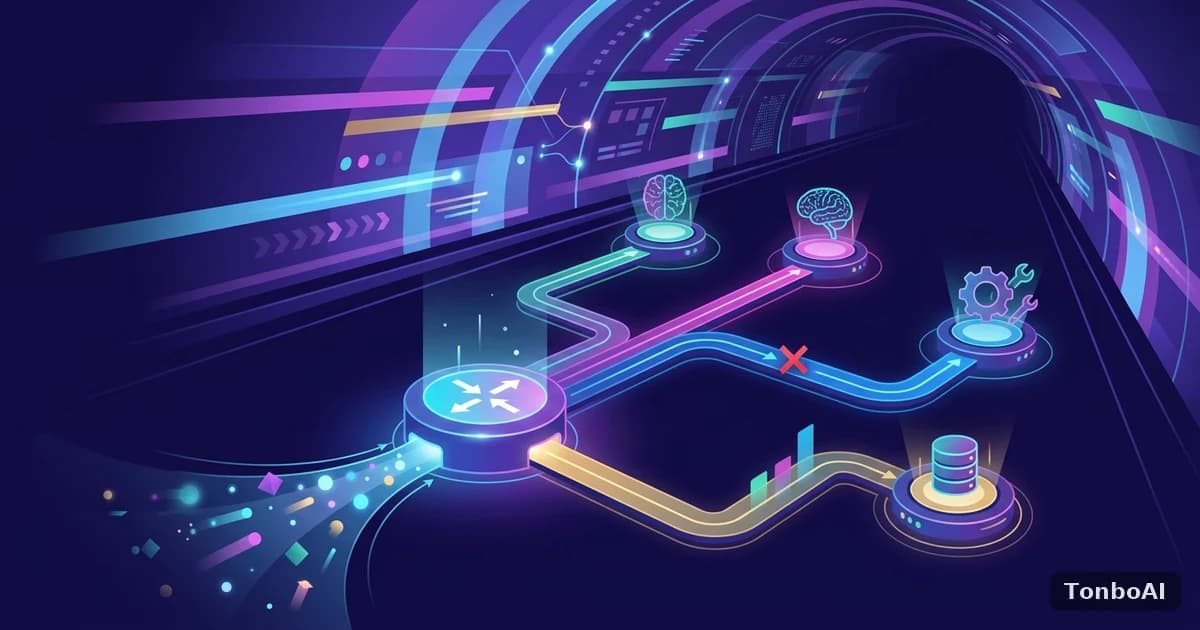
- 连续失败超过阈值后,停止对同一模型的重试,转向备用模型或降级路径,例如缩短上下文、换用更轻的模型。
- 把失败请求的 request-id 记录下来,持续出现时提供给厂商支持排查。
对同时使用多个模型的工作流,过载类错误适合用备用模型兺底,这也是 Tonbo AI 多模型路由要解决的问题之一:与其在一个模型上硬等,不如让同一类任务有可切换的第二选择。
超时类:请求太长还是链路太差
长请求优先使用流式
Anthropic 文档指出,超过 10 分钟的长请求应考虑使用流式接口或批处理接口,并避免在不使用流式的情况下设置很大的 max_tokens,原因是某些网络会在一段时间后丢弃空闲连接,导致请求超时而收不到任何响应。官方 SDK 会校验非流式请求预计不会超过 10 分钟,并设置 TCP 保活。504 timeout_error 同样建议改用流式。
用分层方式排查网络超时
超时不一定来自模型。建议把耗时拆开记录:域名解析、建立连接、发送请求、等待首字节、读取响应,各自设置合理的客户端超时。如果只有建立连接或等待首字节阶段偏慢,且集中在特定网络环境,问题更可能在链路而不是模型;如果首字节正常、总耗时超长,多半是输出太长,应缩小 max_tokens 或拆分任务。
把三类错误落成一套重试规则
- 429 且有 retry-after:等待指定秒数后重试,同时降低并发。
- 429 且无 retry-after,或错误代码指向额度耗尽:不重试,告警并通知负责人。
- 529 或 503:指数退避重试,达到上限后切换备用模型。
- 500:文档建议指数退避重试,持续出现时带上 request-id 联系支持。
- 504 或客户端超时:先判断是否长请求,改流式、拆任务,再重试。
- 400、401、403、404:请求或权限本身有问题,不重试,修正后再发。
官方 SDK 默认对连接错误、限流和 5xx 做两次带退避的自动重试,并遵循 retry-after。自建重试层时,避免与 SDK 重试叠加,否则一次失败可能放大成数倍的请求量。
总结:先归类,再决定等、切还是停
限流看配额,过载看服务端,超时看请求与链路,三者的重试策略各不相同。把错误类型、状态码、是否带 retry-after、request-id 记录进日志,才能在事后判断该调整并发、切换模型还是检查网络。如果你的团队同时用多个模型,并且经常遇到过载和链路抖动,可以把备用模型与 Token 预算一起规划,再对照 Tonbo AI 的多模型路由与 Token 套餐,确认哪种额度方式与你的调用曲线更匹配。
延伸阅读