2026 年大模型 API 定价格局有什么变化
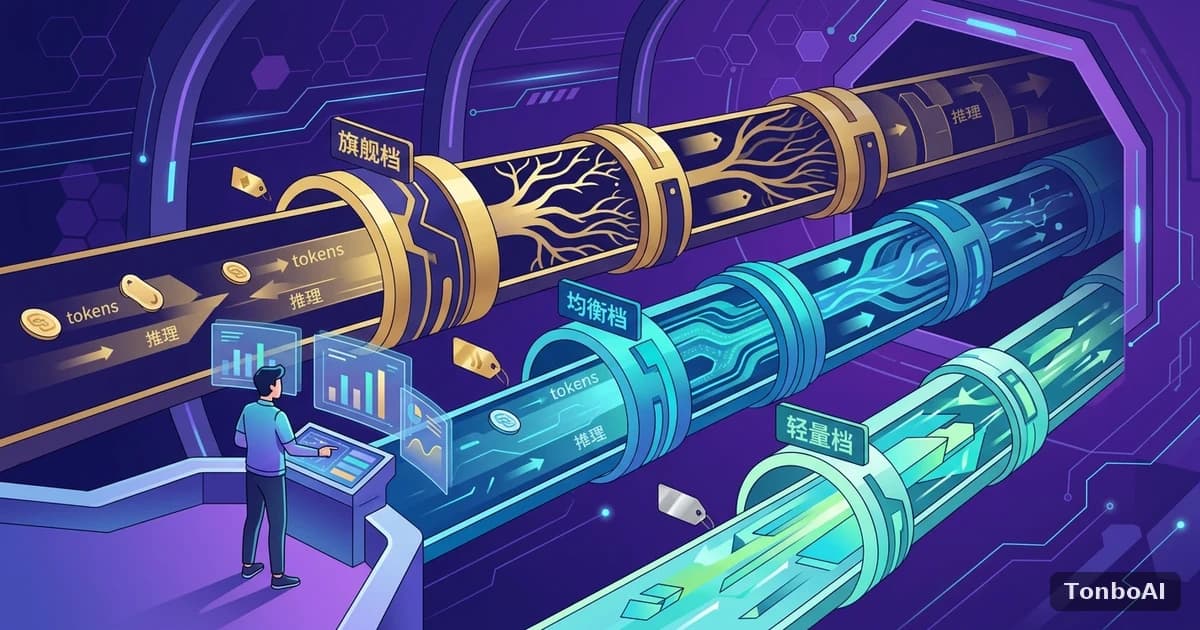
2026 年主流大模型 API 的定价呈现出一个明显趋势:厂商不再靠单一价格打天下,而是拆出旗舰、均衡、轻量多个档位,同一家公司内部的价差能达十几倍。这背后也反映出大模型厂商的商业逻辑变化——单一定价越来越难覆盖从简单任务到深度推理的全部场景,分层定价成为行业共识。开发者选型不能只看“哪家便宜”,而要先想清楚自己的任务复杂度落在哪个档位,再去对比同档位之间的性价比——盲目冲着某个厂商的最低价去,很可能拿到的是能力完全不匹配任务的轻量模型。
主流模型定价对比
以下数据来自各厂商 2026 年公开定价信息整理,行业价格调整频繁,具体请以官方最新公告为准:
| 模型档位 | 代表模型 | 输入价格 | 输出价格 |
|---|---|---|---|
| 旗舰档(强推理) | GPT-5 旗舰档 / Claude Opus 系列 | 约 $5 | 约 $25-30 |
| 均衡档 | Gemini 3.1 Pro / Claude Sonnet 系列 | 约 $2-3 | 约 $12-15 |
| 轻量档 | Gemini Flash 系列 / Claude Haiku 系列 | 约 $0.3-1.5 | 约 $2.5-7.5 |
| 开源/国产模型 | DeepSeek、Qwen 等系列 | 显著低于闭源旗舰档 | 显著低于闭源旗舰档 |
三个选型决策维度
任务复杂度决定档位,而不是预算决定档位
先看任务本身需要什么能力:纯格式化、分类、摘要这类任务,轻量档完全够用;涉及多步骤推理、代码生成、复杂决策的任务,才值得为旗舰档的单价买单。反过来选,只会让预算花在能力过剩或者能力不足的地方。
上下文窗口和“思考 Token”容易被漏算
部分推理模型在计费时会把内部思维链也计入输出 Token,预算测算时容易被忽略;超长上下文(比如超过 20 万 Token)部分厂商还会跳档加价。选型时不能只看表面的每百万 Token 单价,要结合具体任务的上下文长度和是否触发推理计费一起算。
支付方式也是隐性成本
GPT、Claude 等海外厂商官方 API 通常需要外币信用卡支付,申请海外卡、充值虚拟卡本身就有手续费和汇率损失;部分模型支持本地支付方式,直接免掉这部分隐性成本。评估性价比时,这笔账也该算进去。
怎么把单价换算成月账单
列表上的单价是每百万 Token,落到预算上要用一个简单公式:月成本 = 每天请求数 × 30 × (平均输入 Token × 输入单价 + 平均输出 Token × 输出单价)÷ 1,000,000。
举个演示用的假设:每天 1000 次请求,平均每次输入 2000 Token、输出 500 Token,按上表均衡档取输入 $3、输出 $15,单次约 $0.0135,一个月约 $405。其中输出部分占 $225,超过一半,这就是“输出远比输入贵”在账单里的真实样子。以上数字仅用于演示算法,不代表任何产品的实际报价。
算完之后还有两个可以压低成本的口子:对不要求即时返回的批量任务,OpenAI 和 Anthropic 都提供批处理接口,官方说明可享约 50% 的折扣,代价是结果最长可能要等 24 小时;对反复携带同一段长提示词的场景,可以看看厂商是否提供提示词缓存。是否适用、折扣多少,以各家官方文档当前说明为准。
常见误区
- 只对比表面单价,不考虑任务实际会用到的 Token 量级(尤其是输出远比输入贵这件事)
- 为了省钱统一用最便宜的轻量档处理所有任务,复杂任务效果打折还要返工,反而更贵
- 忽略汇率、手续费等支付环节的隐性成本,只看官网标价
- 价格季度性调整频繁,用几个月前的旧数据做预算,容易跟实际账单对不上
常见问题
便宜的国产/开源模型能不能完全替代旗舰闭源模型?
取决于任务类型。在中文理解、成本敏感型批量任务上,国产和开源模型的性价比优势明显;但涉及复杂推理、英文语境下的深度分析等场景,闭源旗舰模型目前仍有能力差距。更现实的做法是按任务分流,而不是非此即彼。
价格对比数据多久需要更新一次?
大模型 API 定价调整频率明显快于传统云服务,新版本发布、竞对调价都可能触发跟进调整。做预算规划时,建议至少每季度核对一次官方最新定价,不要依赖半年以上的旧数据。
总结
定价数字本身会持续变化,但选型逻辑是稳定的:先按任务复杂度分档,再在同档位里比性价比,支付方式和推理计费这些隐性成本也不能漏算。对于需要跨多个模型档位灵活调度、又不想为每次选型反复计算的开发者,Tonbo AI 的多模型路由和 Token 套餐把这套分档逻辑做成了自动化能力,不用每次都手动比价。