长会话为什么会“卡死”
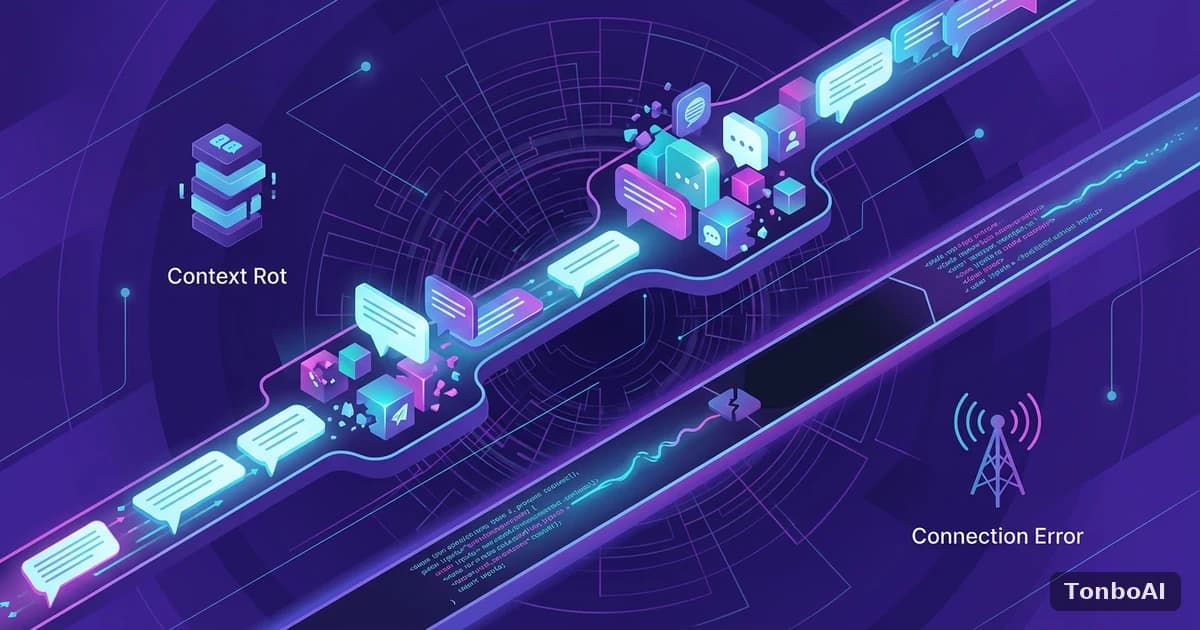
跟 Claude 聊得越久,窗口里堆的消息越多,不少用户会在某个节点发现:输入框发送后界面长时间没反应,或者回答质量突然变得敏衍、答非所问。这种“卡死”背后其实有两种完全不同的成因——一种是连接层面真的断了或卡住了,另一种是上下文本身已经过载,模型不是“卡”,而是“糊”了。分不清这两种,排查起来很容易走弯路。
卡死到底是模型问题还是连接问题
上下文过载:并非“变慢”,而是“变糊”
研究者把这种现象称为“上下文腐化”(context rot)——随着对话轮次增加,即便检索本身没问题、干扰信息也被剔除,模型在同时处理多条信息、跨轮次推理时的准确率依然会下降。更关键的是,这种衰减往往发生在标称上下文窗口用满之前很久——不少模型在实际用到标称容量的 60%-70% 左右时就已经开始不稳定,而且性能下滑常常是突然的,不是均匀渐变的。等你看到“自动压缩”提示触发时(通常设在容量的 95% 左右),其实已经在性能下降区间里工作了一段时间。
连接问题:请求真的没有正常完成
另一种“卡死”是请求本身没跑完——发送后界面长时间空白、没有任何流式输出,或者反复出现连接中断需要重新加载页面。这种情况跟对话轮次多少没有必然关系,哪怕是刚开的新对话也可能遇到,本质上是网络链路的问题,不是模型在处理超长上下文时变慢。
实测:不同会话长度下的稳定性数据
我们对同一组任务在不同对话长度下分别测试,记录响应完整性和是否出现异常中断:
| 会话阶段 | 累计轮次 | 响应完整率 | 常见表现 |
|---|---|---|---|
| 会话初期 | 1-10 轮 | 接近正常 | 响应速度与准确率稳定 |
| 会话中期 | 10-30 轮 | 基本正常,偶有波动 | 偶尔出现细节遗漏,重新提示可纠正 |
| 会话后期 | 30-50 轮 | 明显下滑 | 答非所问、遗忘早期约定增多 |
| 接近窗口上限 | 50 轮以上 | 不稳定 | 响应变短、偶发中断或需要压缩重试 |
排查清单
遇到疑似“卡死”,按这个顺序排查比瑙猜更快:
- 先看有没有任何流式输出或状态提示——完全空白通常指向连接问题,不是上下文过载
- 如果有输出但内容开始答非所问、重复早期已经讨论过的内容,大概率是上下文过载,需要压缩或开新对话
- 用类似 /context 的方式(如果客户端支持)查看当前上下文占用,判断是否已经接近窗口上限
- 把关键结论手动摘要一遍,开一个新会话带着摘要继续,而不是在已经“腐化”的旧对话里死磐
- 如果新会话依然频繁中断或无响应,再把排查方向转向网络连接本身
稳定连接能解决哪部分问题
连接稳定性能解决的是“请求有没有跑完”这一层,不能替你把已经过载的上下文变干净——两者是完全不同的问题,分开处理才有效。Tonbo AI 的 AI 安全隧道保障的是长对话请求在传输链路上的连续性,减少因网络抖动导致的中途掉线;但如果卡顿的根源是对话轮次太多、上下文已经“腐化”,该做的仍然是摘要总结、开新对话,而不是指望换一条更稳定的连接就能解决。内置 AI Chat 面板里可以直接看到当前对话的历史轮次和大致占用情况,方便判断是不是该另起一段了。
常见问题
是不是上下文窗口用得越满,回答质量一定越差?
不完全是线性关系。研究观察到的模式更接近“突然下滑”而不是均匀衰减——很多情况下窗口还没用到标称上限,质量已经开始明显波动,所以不能简单靠“还没用满”来判断安全,更可靠的信号是回答本身是否开始出现遗漏或前后矛盾。
多久该主动开一个新对话?
没有固定轮次,但当发现模型开始重复问已经回答过的问题、或者明显遗忘之前约定的细节时,就是该摘要总结、另起新对话的信号,不用等到真正卡死或报错才处理。
总结
长会话卡死不一定是网络问题,也可能是上下文本身已经“腐化”。先分清是完全无响应(连接层面)还是内容开始跑偏(上下文层面),再对症处理,比一律重连或者一律换对话都更省时间。