开源模型出海接入,现在是什么局面
DeepSeek、Qwen 这类国产开源大模型,在 2026 年已经不只是“能跑起来”这么简单——Qwen3 系列全线采用 Apache 2.0 开源协议,商用友好度明显优于不少海外闭源模型的许可限制;DeepSeek V4 更是拿出了两档 MIT 协议的超大模型。开源本身的门槛已经不高,真正决定“能不能顺畅接入”的,反而是接入路径的选择和网络访问的稳定性。
接入方式盘点
自己搔建 vs 用第三方托管
想接入这些开源模型,大致有两条路:一是自己找云服务器部署模型权重,自己扣算力和运维;二是通过 Together.ai、Groq、Fireworks AI、OpenRouter 这类第三方 API 托管服务,以接近闭源 API 的方式直接调用,不用管底层部署。对大多数应用型团队来说,第三方托管的接入门槛和维护成本明显更低,只是这些服务大多数部署在海外,访问链路依然要经过跨境这一段。
API 协议兼容性也是一道坡
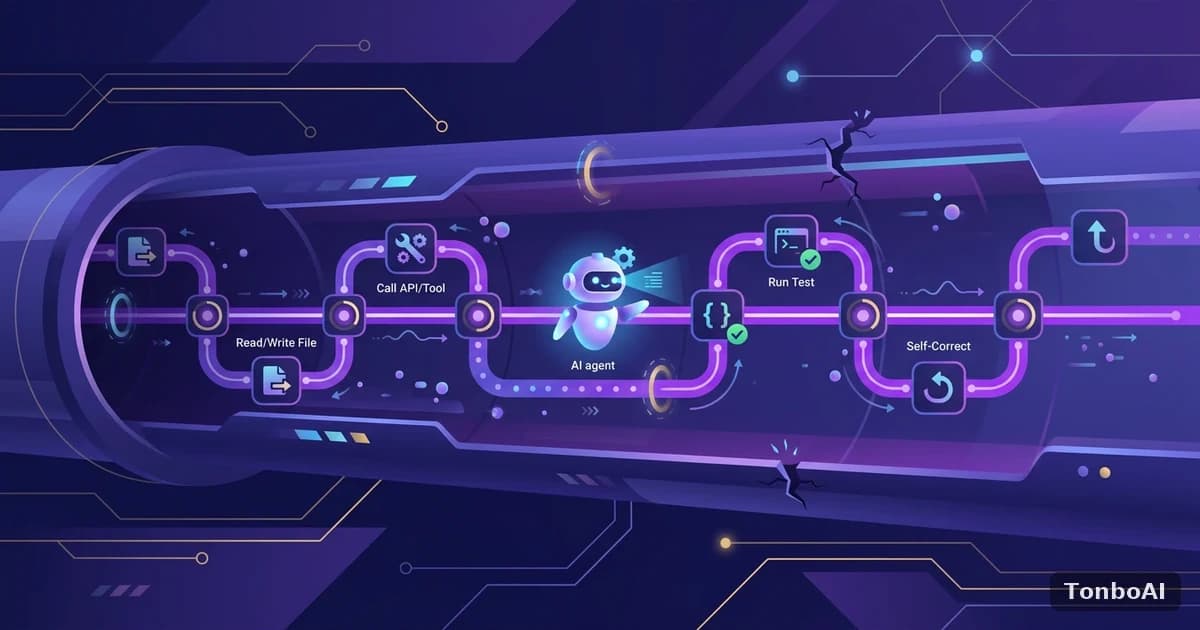
DeepSeek 同时提供了 OpenAI 兼容格式和 Anthropic 格式两种接口,后者更适合需要工具调用能力的 Agent 场景;但直接对接某些平台时,协议格式不完全对齐,还是需要额外的兼容层做转换。这意味着“能调用”和“调用顺畅、功能对齐”之间,还隔着一层接入细节要打磨。
实测数据
| 接入方式 | 典型代表 | 优势 | 需要注意的点 |
|---|---|---|---|
| 自建部署 | 自有云服务器 + 开源权重 | 完全掌控,无第三方限流 | 算力成本高,需自行运维 |
| 第三方 API 托管 | Together.ai / Groq / Fireworks AI | 接入门槛低,接近闭源体验 | 依赖第三方节点的跨境访问稳定性 |
| 聚合路由平台 | OpenRouter 等 | 一处接入多个开源/闭源模型 | 存在中间转发,链路多一环 |
| 模型自身协议兼容 | DeepSeek(OpenAI/Anthropic双格式) | 降低对接改造成本 | 部分平台仍需额外兼容层转换 |
以 DeepSeek V4 Pro 为例,公开渠道信息显示其 API 价格在每百万 Token 0.44 美元(输入)/0.87 美元(输出)左右,相比多数闭源旗舰模型有明显的成本优势,不过跨境访问这些服务节点时,网络链路的稳定性同样会影响实际使用体验。
对开发者的建议
- 优先选择支持标准协议(OpenAI/Anthropic兼容格式)的接入方式,减少后续因协议差异带来的改造成本
- 评估第三方托管服务时,除了看价格,也要实测其跨境访问的响应延迟和稳定性,而不是只看官方宣传的性能数据
- 结构化输出(如JSON)场景,提前做好稳定性测试——不同模型在这类任务上的表现差异可能比预期更大
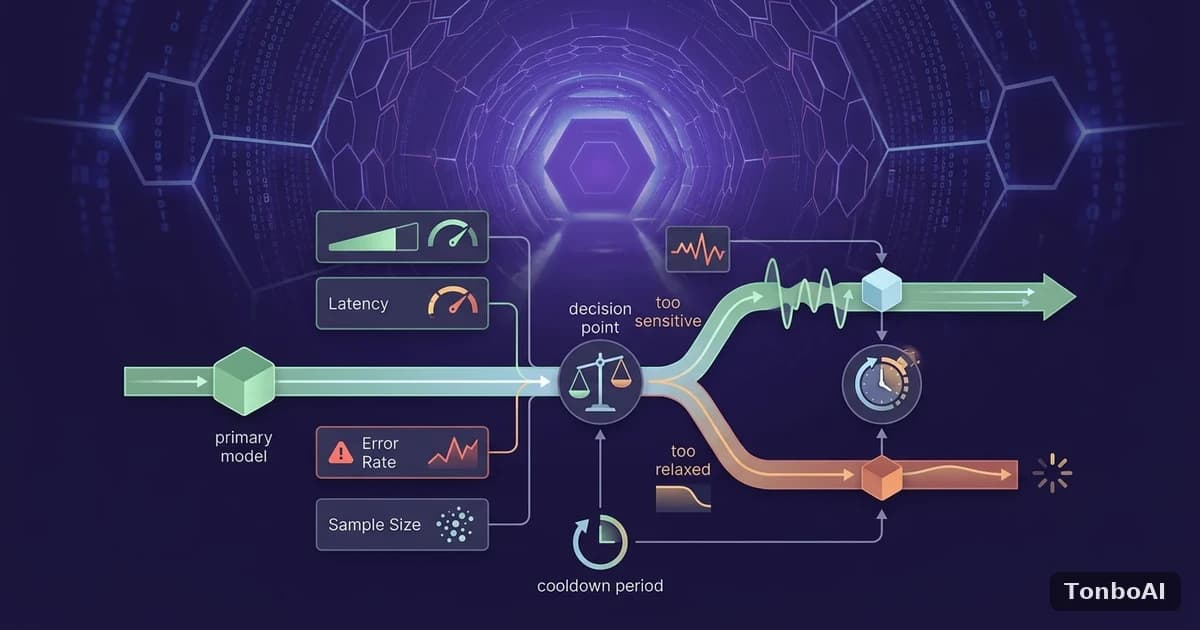
- 关键业务场景建议保留多接入路径的备选方案,避免单一服务商或单一节点故障导致业务中断
常见问题
开源模型是不是一定比闭源模型更便宜?
总体趋势是的,尤其像 DeepSeek V4 Pro 这类性价比档位,价格明显低于多数闭源旗舰模型。但具体到某个第三方托管服务商,价格还会受到该服务商自身定价策略影响,不能简单认为“开源=最低价”,实际接入前还是要对比具体服务商的报价。
自建部署和用第三方托管,该怎么选?
看团队的技术资源和使用规模。长期大规模调用、对数据隐私有严格要求的场景,自建部署的长期成本可能更划算;短期验证、中小规模调用,第三方托管能省去大量运维精力,更适合快速起步。
总结
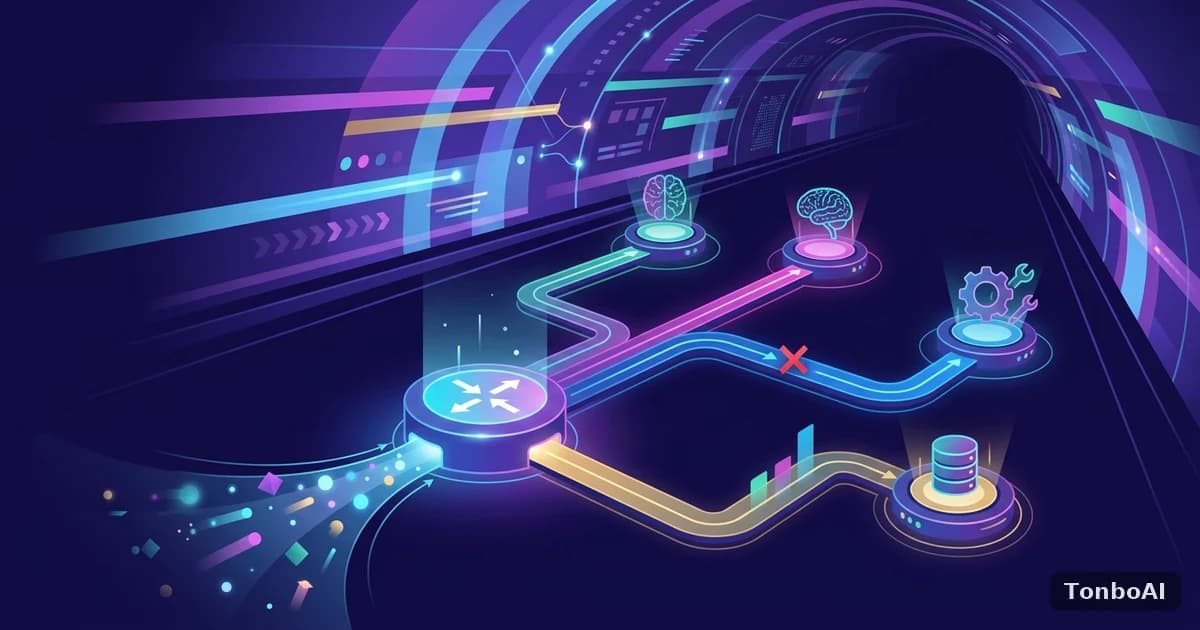
开源模型本身的能力和商用许可已经不是接入的主要门槛,真正影响体验的是接入路径的选择和跨境访问链路的稳定性。对需要稳定调用海外托管服务的开发者和团队来说,连接层面的优化和模型选型同样重要——Tonbo AI 的 AI 安全隧道与多模型路由,能够把包括开源模型在内的多种接入路径纳入统一调度,减少因单一节点或跨境链路问题导致的调用失败。