思考 Token 计费的核心:看不见的推理过程也算输出
使用推理模型时,账单里的输出量往往比屏幕上看到的回答多得多,原因是模型在给出答案之前生成的“思考 Token”同样按输出 Token 计费。OpenAI 与 Anthropic 的官方文档口径一致:推理过程占用上下文窗口,并按输出价格结算,即使接口不返回完整的推理原文。本文对照两家官方文档(核验日期 2026-09-20),讲清思考 Token 的计费逻辑、在响应里去哪儿读出它,以及怎样把它当作一项可预算、可复盘的成本。
如果你曾经拿“回答字数”去估算一次调用的花费,结果与账单差了几倍,问题几乎都出在这里:日志里记录的可见输出,已经不等于账单上的计费输出。
为什么思考 Token 要单独付费
推理本身就是模型在做的计算
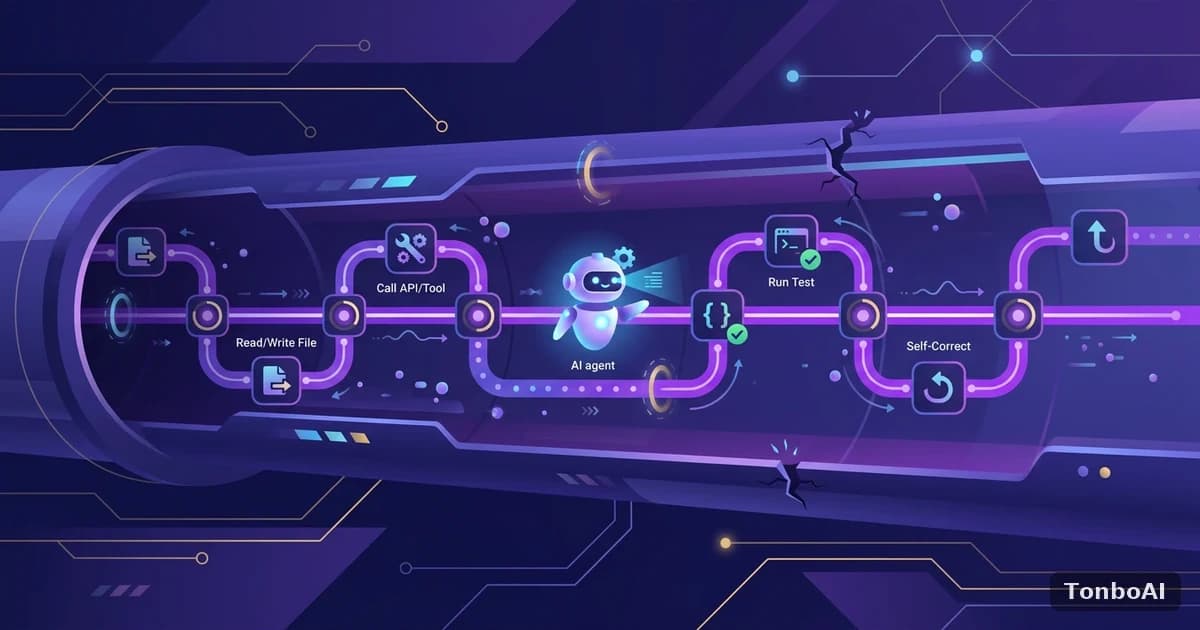
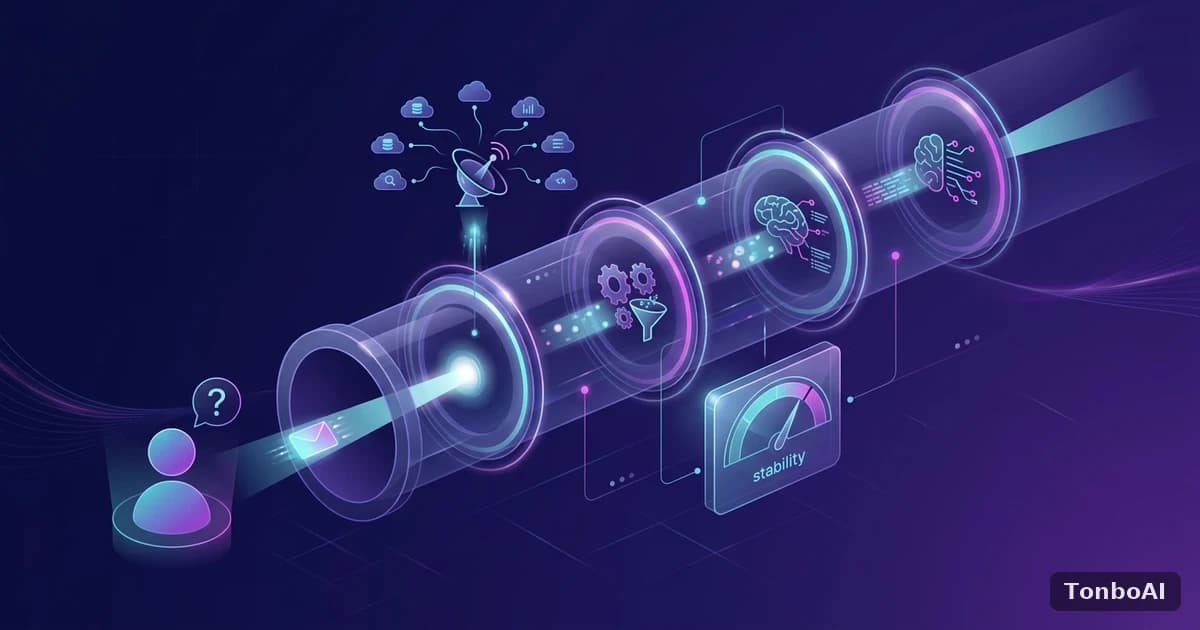
推理模型在输出最终答案之前,会先生成一段内部推理序列,用来拆解问题、尝试路径、检查中间结论。这一段和普通回答一样,是模型逐个 Token 生成出来的,消耗的是同样的推理算力,所以厂商把它归入输出 Token。OpenAI 的推理指南写明,推理 Token 虽然不通过 API 展示,但仍占用上下文窗口,并按输出 Token 计费。
“摘要可见”不等于“只按摘要计费”
Anthropic 的文档把这一点讲得更直白:开启思考并把展示方式设为摘要时,响应里返回的是思考内容的摘要,但计费按模型内部实际生成的完整思考 Token 计算,摘要生成本身不另外收费。文档里的原话意思是,计费的输出 Token 数与响应中可见的 Token 数并不相等。展示方式设为“省略”时,返回的思考字段为空,计费口径不变。
历史轮次里的思考块可能再收一次输入费
多轮对话还有第二层成本。按 Anthropic 文档,较新的模型默认会把之前轮次的思考块保留在上下文里,这些块在后续请求中按输入 Token 计费;较早的模型则会自动剥离历史思考块。也就是说,同样是一段推理,在生成的那一轮按输出计一次,在后续轮次里还可能按输入再计一次,具体取决于所用模型的保留策略,需要以官方“按模型的思考块保留规则”一节为准。
账单上怎么看:从响应里读出思考 Token
两家厂商的字段位置
想知道一次请求里有多少 Token 花在推理上,必须读响应里的用量明细,而不是自己数回答文本。下表整理了本次核验到的字段位置。
| 项目 | OpenAI | Anthropic |
|---|---|---|
| 推理部分的用量字段 | Responses 接口为 usage.output_tokens_details.reasoning_tokens;Chat Completions 接口对应 completion_tokens_details 下的同名字段 | usage.output_tokens_details.thinking_tokens |
| 计费口径 | 按输出 Token 计费,推理 Token 计入其中 | output_tokens 是含思考在内的权威总数,thinking_tokens 只是明细,且不大于 output_tokens |
| 推理原文是否可见 | 不可见,可通过 summary 参数请求摘要 | 可返回摘要,也可设为省略;计费按完整思考 |
| 截断风险 | 达到 max_output_tokens 时状态为 incomplete,可能在产出任何可见文字前就已耗尽 | 思考计入 max_tokens,撞到上限时 stop_reason 为 max_tokens |
| 预留建议 | 刚开始试用时至少预留 25,000 Token 给推理和输出 | 手动预算模式下 budget_tokens 最小 1,024,且必须小于 max_tokens |
Anthropic 的流式响应里,这个明细只会出现在最后的 message_delta 事件中,所以流式场景下别指望在中途读到思考用量。
用一个演示数字算一遍
下面的数字是为了演示计算方法而假设的,不是任何厂商的报价,也不是实测结果。假设输出单价为每百万 Token 10 美元;某次请求输入 2,000 Token,可见回答 350 Token,内部思考 2,650 Token。
- 只按可见回答估算:350 ÷ 1,000,000 × 10 = 0.0035 美元。
- 按实际计费输出(350 + 2,650 = 3,000):3,000 ÷ 1,000,000 × 10 = 0.03 美元。
- 两者相差约 8.6 倍。如果每天有 1,000 次这样的调用,输出侧的日成本是 30 美元,而不是估算的 3.5 美元。
这个例子想说明的是:思考 Token 的比例没有固定值,取决于题目难度、推理强度设置和具体模型,只有读用量字段才知道真实占比。
控制思考开销的四个手段
先给 max_tokens 留足空间,再谈省钱
思考与回答共用同一个输出上限。上限设得太小,模型可能把额度耗在推理上,最终没有可见回答,而你仍要为已生成的 Token 付费。OpenAI 文档专门提醒了这种“只付费、没结果”的情形。Anthropic 文档也说明,为无思考场景设定的 max_tokens 在模型开始深度思考后往往偏小。
用推理强度而不是字数来调节成本
两家都提供了强度控制:OpenAI 有 none、minimal、low、medium、high 等档位(具体档位随模型而异),Anthropic 通过 output_config.effort 设置 low 到 max 的多个级别,其中 low 会在简单任务上尽量少想,medium 允许跳过简单问题的思考。强度是“软引导”,不保证 Token 数,调整后要回到用量字段上验证。
保持思考配置稳定,别破坏缓存
Anthropic 文档说明,在同一段对话中更改 effort 或 budget_tokens 会使缓存断点失效。需要对个别轮次调整思考深度时,官方建议在最新的用户消息里追加提示,而不是改配置参数。
把思考用量做成账单上的独立一行
建议在日志里同时记录 output_tokens 与思考明细,按接口、按模型、按强度分组,算出“思考占比”。当同一类请求的思考占比突然抬升,往往意味着提示词变复杂、模型版本变更或强度默认值被改动。
自己动手验证:一个可复现的对比方法
不必相信任何人给的“平均倍数”,用下面的步骤在自己的业务样本上测一次。
- 选 30 到 50 条有代表性的真实请求,覆盖简单问答和复杂推理两类。
- 固定模型与提示词,分别用低、中、高三档强度各跑一遍,并保存每次响应的完整用量字段。
- 计算每档的平均输出 Token、思考占比,以及带 max_tokens 上限时的截断率。
- 把回答质量抽样打分,找出“再往上加强度已无明显收益”的那一档。
- 把选定的档位、max_tokens 与占比阈值写进团队文档,模型升级后重跑一遍。
常见误区有三个:一是按回答字数估算成本;二是只看单次请求,不看多轮累积;三是为省钱直接关闭思考,导致复杂任务重试次数上升,总成本反而变高。这些都需要用真实用量数据来纠正。
总结:把思考 Token 当作可预算的成本项
推理模型的账单由输入、可见输出和思考输出共同构成,其中思考部分看不见,却最容易被低估。读用量字段、给 max_tokens 留足空间、按强度分档、记录思考占比,是四个最直接的动作。如果你的日常对话以内置 AI Chat 面板为主,可以把本文的验证步骤当作选择 Token 套餐还是按量充值的评估起点,先用一周的真实用量算清楚,再决定额度方案。Tonbo AI 同时提供 Token 套餐与按量充值两种方式,拿到自己的用量数据之后再选,比凭感觉估算更稳妥。
延伸阅读