工具调用跨模型适配:同一个函数,三家要写三种样子
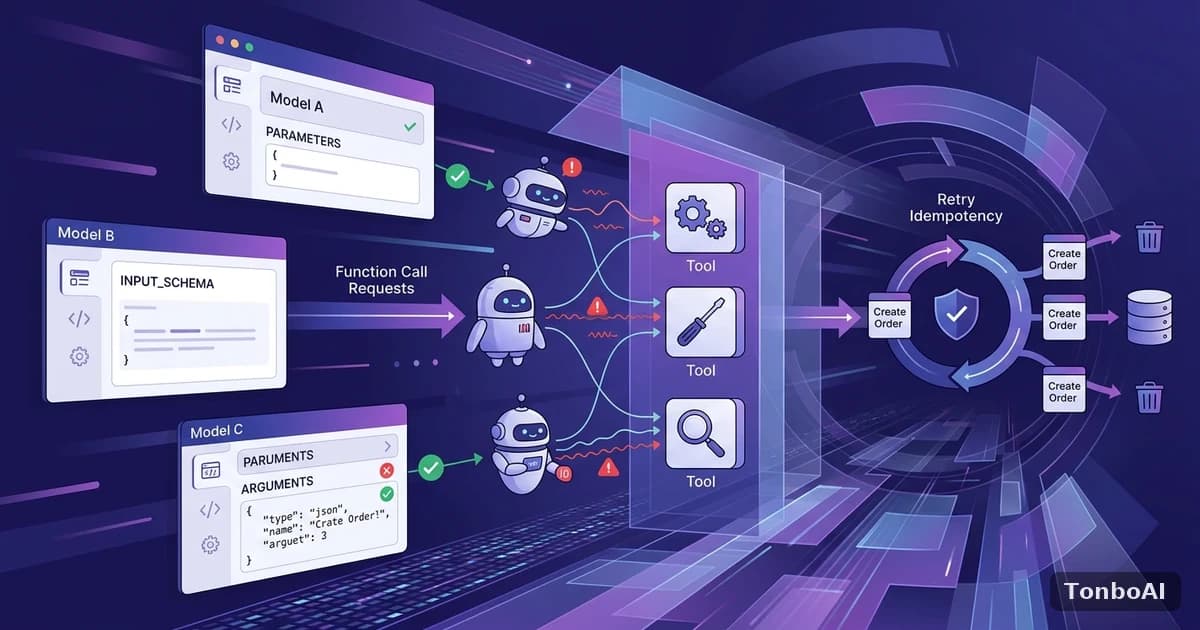
做 AI 工作流的人迟早会遇到同一个场景:业务里有一组内部函数,比如查订单、查库存、发工单,希望 OpenAI、Anthropic、Gemini 三类模型都能调用。表面看,三家都是“声明函数、模型选择调用、你执行后回传结果”,但字段名、参数返回类型、强制调用的写法、调用 ID 的配对规则并不相同。适配不到位,线上表现通常是:参数解析偶发报错、结果回传后模型“失忆”、重试把订单重复创建。本文对照三家官方文档(核验日期 2026-10-01,具体字段以各家最新页面为准),整理差异和一套带幂等保护的重试策略。
定义与返回:字段名和参数类型不同
函数定义:parameters 还是 input_schema
OpenAI 的函数声明包含 type、name、description、parameters 和 strict 几个字段,其中 parameters 是描述入参的 JSON Schema。Anthropic 的工具定义用 name、description 和 input_schema,另有可选的 input_examples,用来给复杂嵌套参数提供经过 Schema 校验的示例;工具名需匹配 ^[a-zA-Z0-9_-]{1,128}$。Gemini 的函数声明同样由名称、描述和 parameters 构成,名称只允许下划线或驼峰风格。三家的 Schema 子集也有差异,所以统一维护一份“内部工具描述”,再由适配层生成三种格式,比在业务代码里手写三份更稳妥。
参数返回:字符串还是对象
这是最容易踩的一处。OpenAI 返回的 arguments 是 JSON 编码后的字符串,需要你自己解析,并且每次调用带有唯一的 call_id;Anthropic 的 tool_use 内容块里,input 直接是对象,并带有块自己的 id;Gemini 的函数调用里 arguments 为对象,同样带有调用 id。解析层的做法是:统一入口先判断类型,字符串则解析、对象则直接使用,解析失败按“参数损坏”归类,而不是当成工具执行失败。
结果回传:用哪个字段配对
OpenAI 通过 function_call_output 消息回传,用 call_id 指向具体调用,output 通常是字符串;Anthropic 以 tool_result 块回传,需要带上对应 tool_use 的 id;Gemini 则以函数响应的形式回传。无论哪家,一次回复里有多个并行调用时,必须逐个回传且 ID 一一对应,漏掉一个就可能让下一轮请求被拒绝或让模型误判。
调用控制:tool_choice 与并行调用
强制调用不是处处可用
OpenAI 的 tool_choice 有自动、必须调用、指定某个函数和限定允许集合四种;其中 allowed_tools 可以缩小可调用范围而不用改动完整的工具列表,文档提到这对提示词缓存有帮助。Anthropic 提供 auto、any、tool、none 四种选项,但文档特别说明:部分模型与设置不支持强制调用,any 和 tool 会直接返回 400,例如开启手动扩展思考时,以及文档列出的若干新模型;这些场景下推荐用 auto 加严格工具调用,或改用结构化输出。Gemini 的模式包括 auto、any、none,以及要求严格遵循 Schema 的 validated。因此适配层里要为每个模型维护“是否支持强制调用”的能力表,不支持时降级为 auto 并在提示里明确要求调用某个工具。
并行调用与缓存
OpenAI 文档说明,GPT-5 起的模型支持并行函数调用,可以把 parallel_tool_calls 设为 false,保证每次最多只调用零个或一个工具。Anthropic 文档提醒,使用提示词缓存时,修改 tool_choice 会让缓存的消息块失效,而工具定义与系统提示仍可保持缓存。如果你的工作流里 tool_choice 经常切换,要把它算进缓存命中率里,相关计算方法可以参考提示词缓存的命中条件与命中率算法。
| 维度 | OpenAI | Anthropic | Gemini |
|---|---|---|---|
| 入参 Schema 字段 | parameters,可配 strict | input_schema,可配 input_examples | parameters |
| 参数返回形态 | JSON 编码的字符串 | 对象 | 对象 |
| 调用标识 | call_id | tool_use 的 id | 调用 id |
| 强制调用 | required 或指定函数 | any 或 tool,部分模型返回 400 | any,或 validated 严格模式 |
| 严格模式要求 | additionalProperties 为 false,字段全部必填 | 严格工具使用,限制见结构化输出文档 | validated 模式 |
重试策略:先判断失败发生在哪一层
三层失败要分开处理
- 模型层:没有产出工具调用、参数缺字段、参数类型不对。可以带上具体的校验错误重试一次,再换备用模型。
- 工具层:函数本身执行失败或超时。把错误信息作为工具结果回传,让模型决定改参数、换工具或直接告知用户,而不是由适配层悄悄重跑。
- 网络层:请求没有送达或响应丢失。这是最危险的一类,因为你不知道工具是否已经执行。
幂等是重试的前提
对“只读”工具,重试几乎没有代价;对“写入”类工具,比如创建订单、发送通知,重试前必须有幂等键。常见做法是用模型返回的调用 ID 加会话 ID 生成幂等键,传给下游服务,下游收到重复键直接返回上一次的结果。没有幂等保护的写入工具,不要放进自动重试路径,应改为失败即告警。
错误结果要回传,不要吞掉
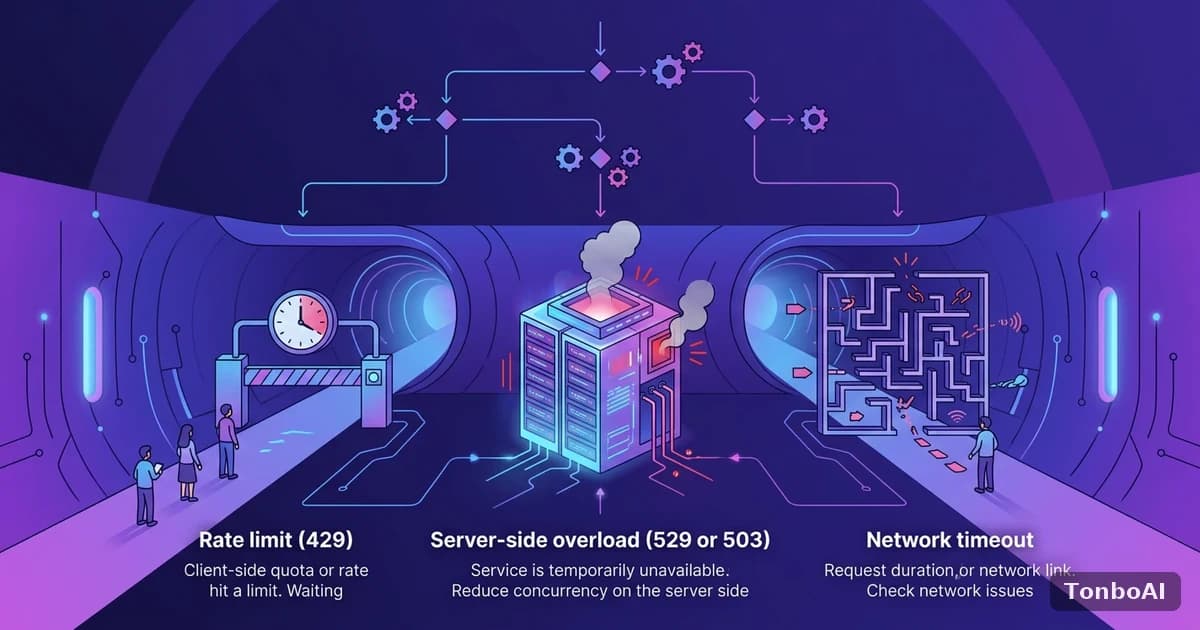
Anthropic 的 tool_result 支持标记错误结果,其他两家则通常把错误写进输出文本。统一的做法是:工具失败时仍然回传一条结构化的错误说明,包含错误类型、是否可重试、建议的下一步。这样模型能基于事实继续对话,不会因为缺少结果而重复发起同一个调用。限流与过载类错误如何区分、何时等待,可以对照API 报 429、529 或超时的三类错误区分。
适配层落地清单
- 维护一份内部工具描述,由适配层生成三家各自的声明格式。
- 统一解析入口:字符串参数先解析,对象参数直接用,失败记为参数损坏。
- 维护模型能力表:是否支持强制调用、是否支持并行调用、是否支持严格模式。
- 多个并行调用逐个回传,保证 ID 一一对应,并设置单个工具超时。
- 写入类工具必须带幂等键,否则不进入自动重试。
- 日志记录工具名、调用 ID、参数哈希、重试次数和最终结果,便于事后核对。
当主模型过载或工具调用连续失败时,让同一任务能切到备用模型,是适配层的收尾环节,其机制见多模型路由自动切换的原理。
总结:差异收进适配层,重试交给幂等
工具调用的跨模型问题,大多来自四个细节:参数类型、调用 ID、强制调用能力、重试副作用。先把前三项收进适配层,再用幂等键解决第四项,剩下的才是提示词和工具描述的打磨。如果你需要在同一个入口对比多个模型的工具调用表现,可以通过 Tonbo AI 的 OpenAI 兼容接口接入,并在内置 AI Chat 面板里用同一组工具描述做对照测试,再决定回退顺序与重试预算,接入方式见OpenAI 兼容 Token API 接入指南。