一次请求失败背后,自动切换在做什么
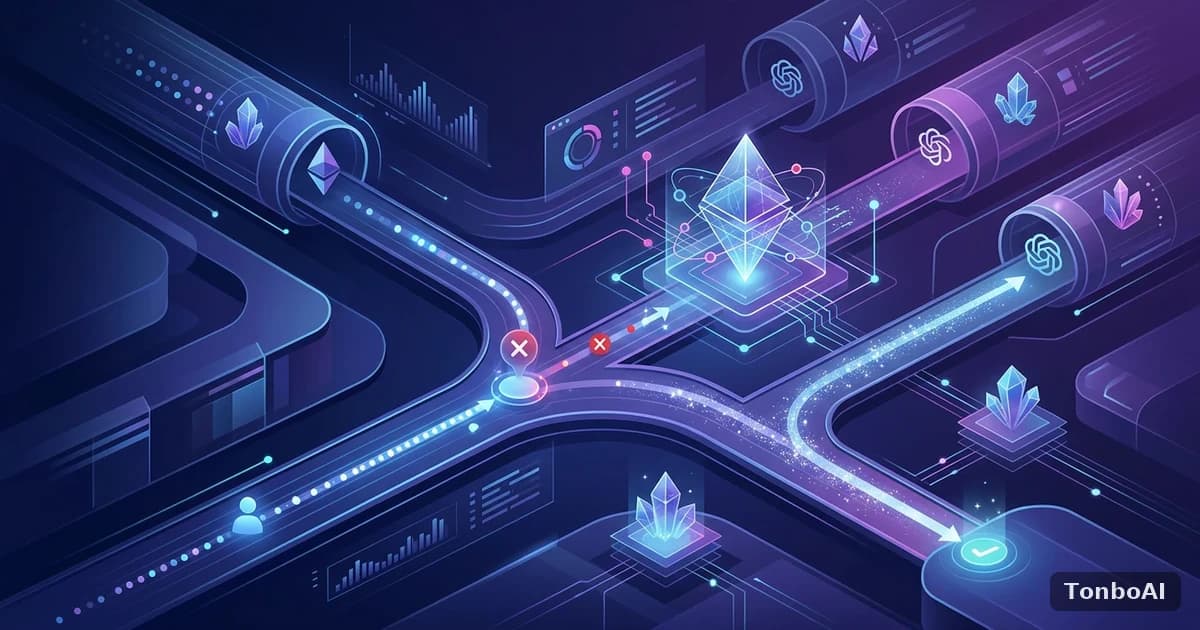
用单一模型接口的人,遇到“服务暂时不可用”“请求超时”这类报错,通常只能刷新重试或者干等。多模型路由的自动切换要解决的正是这个:当主力模型返回限流、超时或服务错误时,请求被自动改道到备用模型继续处理,整个过程通常发生在毫秒级别,用户几乎感知不到中断——这跟“报错后手动换一个工具重新问一遍”完全是两种体验。
路由决策的三个判断维度
故障类型判断
不是所有报错都值得切换。限流(429)、服务端错误(5xx)、请求超时、认证失败、模型暂时不可用,这些是明确的切换触发条件;但如果是请求内容本身的问题(比如参数格式错误),换个模型也解决不了,应该直接报错而不是无意义地切来切去。
故障域判断:切模型,还是切服务商
很多人以为“换个模型”就够了,但如果问题出在服务商整体基础设施(比如某次大规模服务中断连带影响了旗下所有模型),切换到同一家的另一个模型没有意义—2025 年 11 月的一次大型云服务商故障就曾连带影响多个依赖同一基础设施的 AI 服务。真正有效的故障转移链需要跨越不同服务商,而不只是同一家的不同模型档位。
重试预算判断
切换不是无限重试。合理的设计会给每个环节设置重试次数上限和退避策略,避免因为持续报错陷入“疯狂重试”反而加剧拥堵;超出预算后才真正切到下一个备用选项,而不是每次报错都立刻全部重试一遍。
秒切的技术链路
从用户发出请求到拿到备用模型的回答,中间会经过几个自动判断节点:先按正常路径尝试主力模型,如果在设定时间内没有得到成功响应或返回了明确的故障信号,路由层立刻判断故障类型是否满足切换条件;满足条件且没有超出重试预算时,请求被无缝改道到备用模型继续处理;如果备用模型同样失败,链条会继续尝试下一个选项,直到有模型成功返回或者所有选项耗尽。整个过程里,用户看到的只是“回答稍微慢了一点点”,而不是一次失败的报错。
Tonbo AI 的多模型路由调度内置了这套故障转移逻辑,请求异常时的切换对用户是无感的,不需要额外配置。
什么场景最受益
- 长任务执行中途(比如代码生成、多步骤推理),中断后需要重新开始的成本很高
- 团队协作场景下,任何一次请求失败都会打断多人协同的工作节奏
- 对响应时效要求高的场景,等待人工发现报错再手动换模型的时间成本不可接受
- 依赖单一模型服务商、缺乏跨服务商备份的个人开发者或小团队
与手动切换模型的对比
| 维度 | 手动切换 | 自动故障转移 |
|---|---|---|
| 发现问题到切换耗时 | 依赖用户主动察觉,数十秒到几分钟 | 毫秒级自动触发 |
| 切换范围 | 用户凭经验选一个替代模型 | 按预设故障转移链跨模型、跨服务商 |
| 上下文/任务连续性 | 需要手动复制粘贴重新开始 | 当前会话与任务通常可以延续 |
| 是否需要用户判断故障类型 | 需要 | 由路由逻辑自动判断 |
常见问题
自动切换会不会切到质量差很多的模型,导致回答变差?
取决于故障转移链的设计——好的路由策略会预设质量相近的备用档位,而不是随便切到最便宜的模型。目标是保证任务能继续完成,不是牺牲质量去换可用性,遇到必须用旗舰模型深度处理的任务,备用链也应该优先匹配同档位模型。
单一模型服务商的可用性到底有多大风险?
行业报道显示,主流大模型 API 服务商过去一段时期的可用性并未做到接近100%——某家服务商 90 天内的正常运行时间一度在 99% 以下,换算下来意味着每 90 天可能有超过 20 小时处于不可用或降级状态。只依赖单一服务商,这些时段就是实打实的服务中断。
总结
多模型路由自动切换要解决的核心问题,是把“发现故障→判断类型→选择备用→重新发起”这一串原本要人工完成的操作,压缩到毫秒级的自动决策里。故障域判断和重试预算设计得好不好,决定了切换是真的解决了问题,还是只是把报错挑个地方。