真正卡住你的,不是“连不上”
凌晨赶稿,ChatGPT 的输入框转了半分钟还在转;写到一半,Claude 的回复突然断在句子中间。很多人第一反应是“网速不行”,其实不是。海外 AI 服务的访问质量,很少坏在“能不能打开”这一步,更多坏在“能不能一直稳着用下去”。
这两件事完全不是一回事。能打开网页,不代表 API 调用能成功;今天连得顺,不代表明天高峰期不掉线。下面这篇,我们不谈虚的,从几类真实在用 AI 干活的人讲起,再把决定体验好坏的那几个藏在水面下的指标摄开说清楚。
四种人在搜这件事,需求差得很远
搜“海外 GPT 怎么访问”的,不是一群技术极客,而是已经把 AI 嵌进日常工作流、断一次就要骂街的职业用户。他们的痛点其实各不相同。
写东西的人,最怕思路被打断
自媒体、文案、写小说的,每天高频调 GPT-4 和 Claude 做长文生成、改写、翻译。对他们来说,一次对话中断就是一次思路断裂。延迟超过 800ms,敲字的节奏就乱了;连续几次超时,干脊退回到“网页版复制粘贴”的原始干法。这类人对“顺不顺”比对“快不快”敏感得多。
写代码的人,要求更狠
用 Cursor、GitHub Copilot,或者直接在终端调 OpenAI API 的开发者,容忍度更低。一次 10 秒的握手超时,IDE 插件可能直接崩给你看;IP 频繁跳变,还会撞上平台的异常验证,账号被临时冻结。他们想要的,是一条“用起来跟本地网络没两样”的隐道,而不是时好时坏的连接。
跨境团队,断的是整条协作链
一支产品团队散在深圳、新加坡、旧金山几地,靠 Notion AI、Linear、自建知识库协同。只要有一端访问不稳,整条链就卡住。这种场景下“GPT 能不能访问”只是冰山一角,水面下是一整套 SaaS 工具链的连通性。
做研究的人,断在关键查询最致命
高校研究员、咨询分析师,要查 Google Scholar、arXiv 和各种开放数据集,再拿 AI 辅助做文献综述。他们流量不大,但对可用性近乎苛刻——偏偶断线总挑在最关键那次查询发生,成本极高。
决定体验的,是几个你平时看不见的指标
判断一条线路好不好用,光看“能打开网页”远远不够。下面几个指标,才是真正分水岭。
就近接入,但“近”不等于“好”
物理距离仍然是延迟的第一来源。OpenAI 的 API 服务器主要在美西(圣何塞、洛杉矶)和美东(弗吉尼亚),所以对海外用户来说,走香港、东京、新加坡中转往往比硬连美西更稳——注意,是更稳,不是更快,关键差在抖动小。
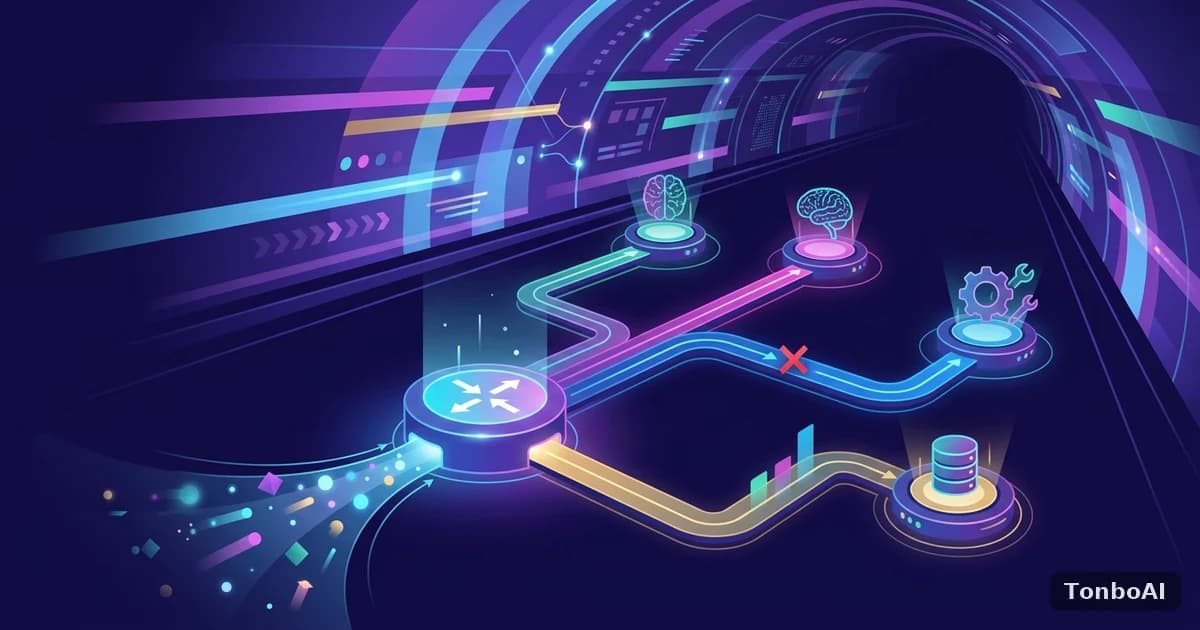
但地理上近的节点不一定最优。有些节点位置近,却卡在国际出口拥堵或者运营商限速上。靠谱的做法是同时维护多套路由表,根据实时探测数据动态切换。Tonbo AI 的节点池覆盖 15 个以上地区,香港 CN2、东京 Azure、新加坡 AWS 都在内,单次握手失败后的切换控制在 3 秒以内。
丢包、抖动、MTU,三个隐形杀手
很多“能打开但用着别扭”的体验,问题都出在这三个地方。
- 丢包率。TCP 重传一旦超过 2%,ChatGPT 那种基于 WebSocket 的长连接就会反复断开。线路质量过得去的话,丢包应该压在 0.5% 以下。
- 抖动。延迟忽高忽低比延迟的高低本身更影响手感。海外到美西通常是 150 到 250ms 之间,这个量级本身没问题;可一旦抖动超过 50ms,输入卡顿就明显能感觉到了。
- MTU 适配。某些网络环境对 MTU 有限制,大包传不过去就会出现莫名其妙的失败。客户端能自动分片、调整 MSS 的话,这类隐形故障基本能绕开。
终端覆盖得够不够全
专业用户的设备不止一台。一个只能在浏览器里用的方案,对他们几乎没意义。
Windows 和 macOS 要的是系统级代理或者 TUN 模式,让 Cursor、VS Code 插件、Python 脚本都能走进优化通道;手机端则靠 VPN 扩展或配置导入,在浏览器和原生 App 之间无缝切。再往上还有更挑剔的需求——Docker 容器内的网络隔离、WSL2 子系统的路由穿透、路由器层面的全屋覆盖。Tonbo AI 这边 Clash 订阅、Surfboard 配置、原生 WireGuard 都支持,从笔记本到一整个团队网关都能接。
别一上来就全局代理
AI 工具几乎从不单独用。一个常见流程是:ChatGPT 出大纲,Figma 画原型,Slack 同步给海外同事,最后 Zoom 上演示。这意味着加速不能只盯着一个域名,而要对几十个 SaaS 平台做流量识别和分流。
新手最容易踩的坑就是“全局代理”——所有流量一股脑走海外节点,结果本地视频、企业 IM 反而被拖慢。智能分流(Split Tunneling)的价值就在这儿:认目标地址,AI 相关的走优化线路,本地服务直连,各走各的。
免费工具能用,但很难一直用
不是说免费方案完全不能碰,而是它的核心毛病是“不可预期”:你不知道明天这个节点还在不在,也不知道此刻有多少人和你挤同一条带宽。把这点和付费服务摆一起对比,差距就清楚了。
| 维度 | 免费公共代理 / 浏览器插件 | Tonbo AI 网络加速服务 |
|---|---|---|
| 稳定性 | 节点共享,高峰期拥堵,可用率大致 60% 到 80%,没有任何承诺 | 独享带宽池、多节点热备,月度可用性按 99.5% 保障 |
| 节点覆盖 | 常见就 3 到 5 个公共节点,IP 容易被识别封禁 | 15 个以上地区接入点,含香港、东京、新加坡、美西、美东 |
| 客户端 | 多是浏览器插件,不支持系统级代理和移动端 | Windows / macOS / iOS / Android / Linux / 路由器全平台 |
| 隐私 | 流量经过来路不明的第三方服务器,日志政策不透明 | 零日志架构,TLS 1.3 全链路加密,不记录用户行为 |
| 办公协同 | 每个工具都要手动配,没有智能分流 | 内置 200 多个 SaaS 平台规则,AI 工具和协作软件自动识别 |
对那些已经把 AI 嵌进日常工作的人来说,这种“说不准”本身就是成本。省下的订阅费,往往会在某个赶稿的深夜以加倍的代价还回来。
几个被反复问到的问题
网页能打开,为什么 API 反而调不通?
这两边的识别机制根本不一样。网页版主要看 IP 归属和浏览器指纹,而 API 端,尤其是 GPT-4,对请求来源查得更细,TLS 指纹、TCP 时间戳这些深层特征都在审。有些“能看网页”的代理改动了出站特征,结果就被 API 端拒了。做得专业的加速服务会保持协议栈一致,不去触发这类防护。
用加速器会不会被 AI 平台封号?
封号一般是因为“行为异常”,而不是单纯因为你用了代理。真正的触发点是:同一个 IP 短时间狂注册账号、请求频率反常,或者 IP 本身早就进了已知代理黑名单。选用纯净住宅 IP 池、别在公共节点上高频操作,风险就低很多。Tonbo AI 的商业级节点用的是独立 ASN 段,跟数据中心 IP 区分度高。
团队一起用,要每台单独配吗?
团队别一台台配了,直接上组织级网关——在路由器或软路由上部署一次,全屋设备零配置接入,还能统计成员用量、分级授权。十人以上的分布式团队,可以再申请专属线路优化,固定 IP 段方便内部白名单管理。
手机和电脑上的体验一样吗?
看协议。IKEv2 在 WiFi 和 4G/5G 之间切换时重连更快,WireGuard 则在 CPU 占用和耗电上更省。iOS 建议开“按需连接”,检测到特定域名请求才建隐道,省得后台一直耗电;Android 这边用 Surfboard 之类的客户端能做到更细的应用分流。
除了 ChatGPT,别的 AI 工具也能优化吗?
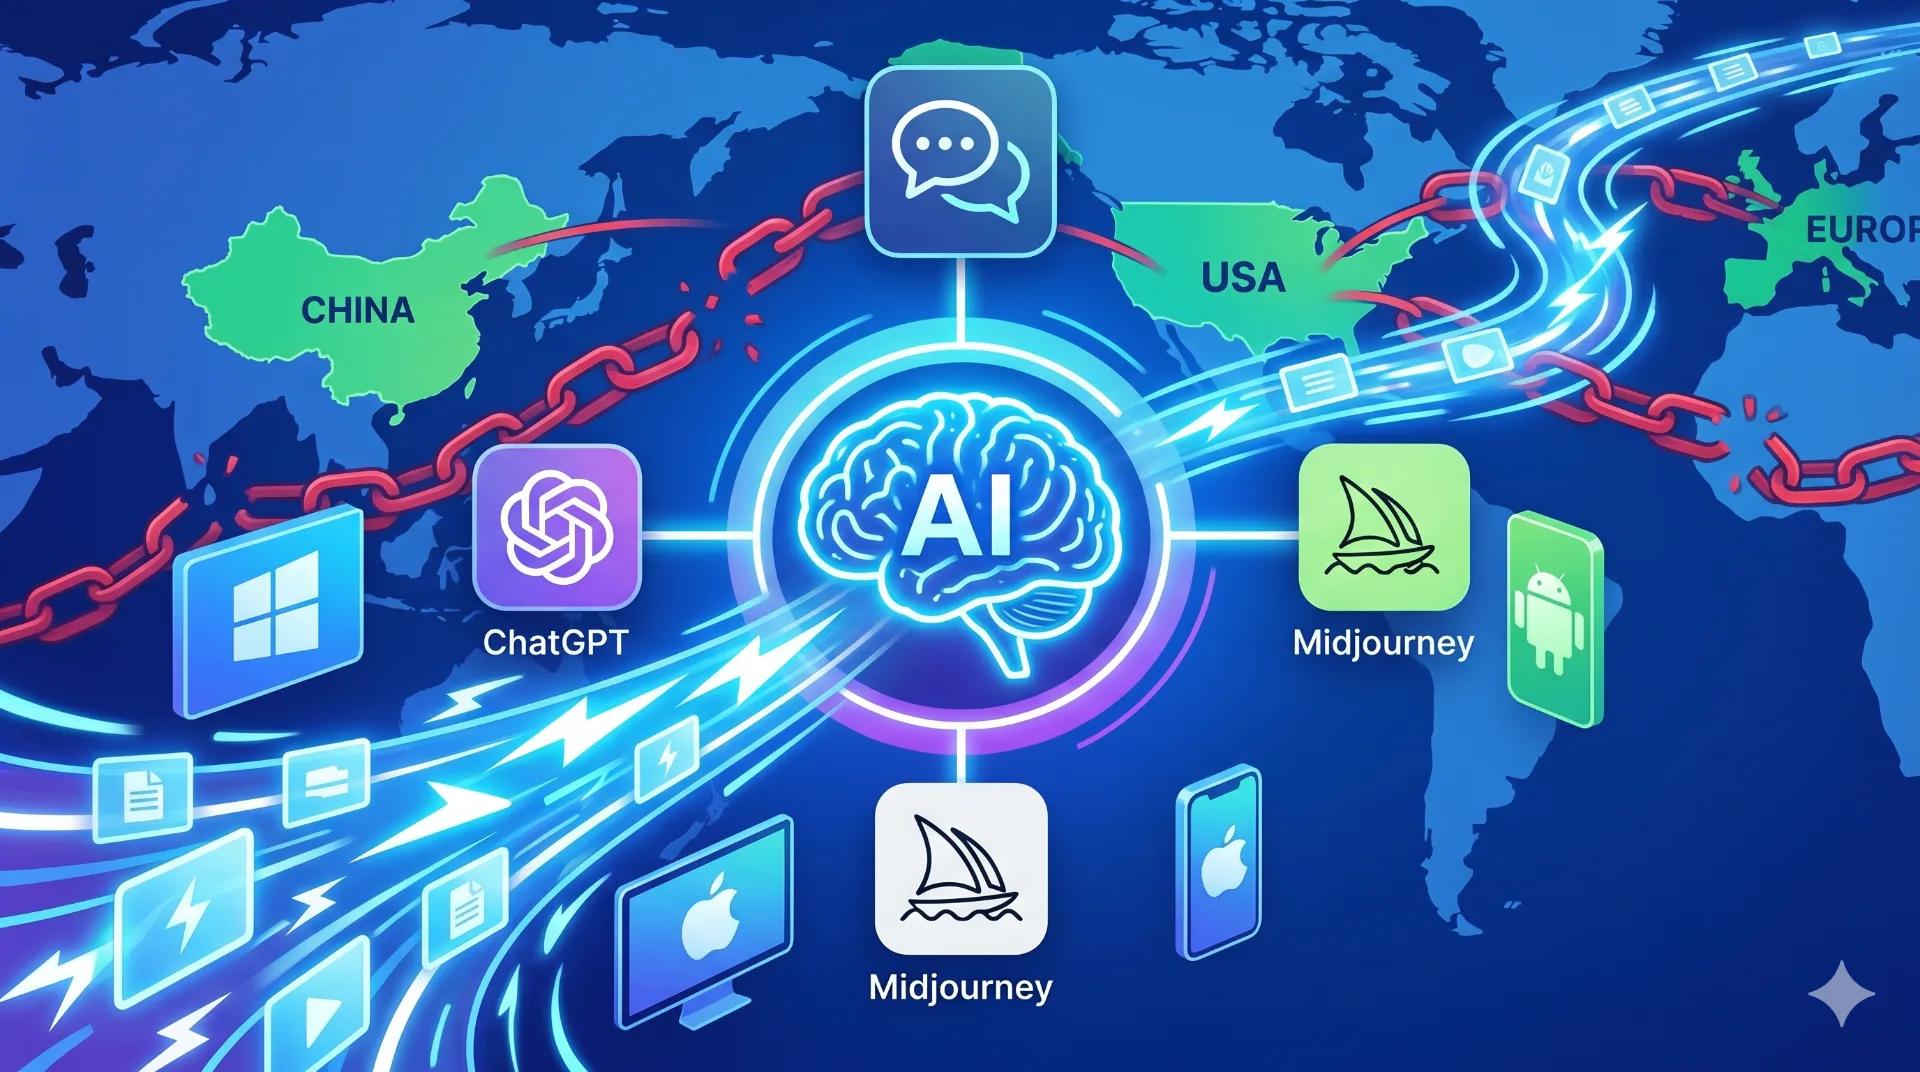
能。Claude、Gemini、Perplexity、Midjourney,还有 Stable Diffusion 的云端版,都在优化范围里。说到底,“GPT 怎么访问”只是大家搜索习惯的一个切口,真正要解决的是海外 AI 服务整体可达性。Tonbo AI 的规则库一直在更新,新平台一般 48 小时内就完成适配测试。
写在最后
稳定地用上海外 AI 工具,早就不是什么锦上添花的事,而是知识工作者的基础设施。能少在凌晨三点对着转圈的输入框发火,本身就值回投入。
如果你想自己试试,可以去 Tonbo AI 上拿全平台客户端跑一轮,新用户能体验基础套餐的完整功能。要是正在搭 AI 驱动的内容团队或远程开发小组,也可以约一次一对一的架构咨询,聊聊组织级网关怎么落地。