AI 专用隧道和通用隧道差在哪?不只是市场话术
"AI 专用隧道"听起来像市场部编的词,但它和通用安全隧道在技术实现上确实有三条硬差异:路由策略从"最短路径"变成"AI 服务最优路径"、长连策略从"随机重连"变成"会话保活"、加密规格从"仅 TLS"变成"AES-256 全程加密"。本文一条条拆给你看,也给你一张实用的对比表做选型参考。
差异 1:路由策略从"最短路径"变成"AI 最优路径"
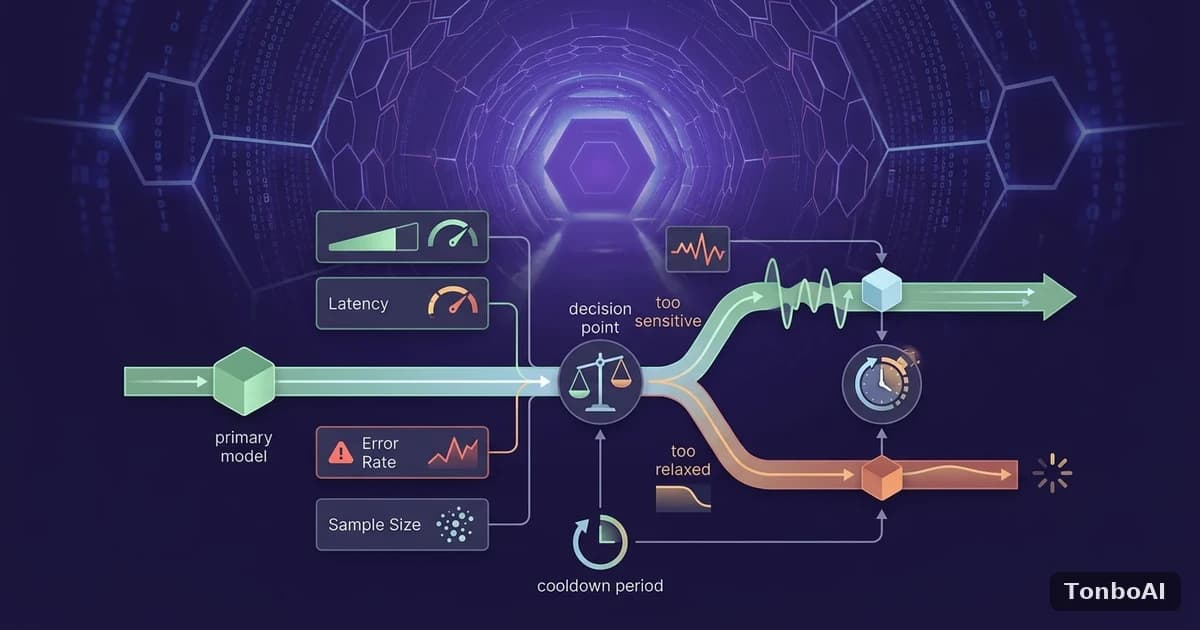
通用安全隧道的路由逻辑很简单——找距离用户最近、负载最低的节点。但"最近"不等于"访问 Claude 最快",因为 Anthropic 的主要推理集群在北美,用户在亚洲从就近节点出流量反而要绕行大半个地球。AI 专用隧道把这层地理预判移到了接入层。
通用隧道只看节点健康
一个用户在亚洲发起请求,通用隧道会从候选节点里挑一个 ping 最低的(比如香港或东京)。但这个节点到 Claude 服务商的回程路径并不直接——可能先走日本→美西→美东→Anthropic 出口,中间又多了 3 跳。
AI 专用隧道看的是 AI 服务商地理分布
TonBo 的路由决策会综合三件事:客户端位置、AI 服务商主要推理集群位置、当前链路的实时丢包和延迟。访问 OpenAI 优先走与美西最近的出口、访问 DeepSeek 优先走亚太内循环、访问 Gemini 优先走 Google POP 直连。整个过程对用户透明,但在首包延迟和稳定性上拉开一个身位。
差异 2:长连策略为 Agent 循环而设计
对话式 AI 和 Agent 任务的网络流量特征和普通 Web 完全不同——一次调用可能持续分钟级,Agent 循环可能跑小时级。通用隧道的长连机制面向的是 SSH、远程桌面这些低强度长连场景,遇到 AI 场景会暴露一堆短板。
对话式流量对断连极度敏感
流式输出的 Token 按毫秒颗粒度到达。任何一次 TCP 连接中断,前端界面就会卡住、Token 流会回滚,用户体感是"AI 卡了"。通用隧道遇到中间节点切换(比如负载均衡自动调度)会直接断流让客户端重连,损失当前对话上下文。
会话保活与心跳,Agent 10 小时不断流
AI 专用隧道在接入层做了三件事:一是会话保活,单条流可以在 10 小时以上时间窗内保持;二是心跳探测,链路异常时主动切换出口节点但对应用层透明;三是自动重连上下文保留,极端情况下短暂重连也不会让 Agent 的 session token 失效。
差异 3:加密规格守护 prompt 和 API Key
你在 ChatGPT 里粘贴一段内部文档、在 Claude 里跑一次数据分析、在 Token API 里传 API Key——这些数据里经常夹带企业机密。通用隧道只在"用户→接入点"这一段走 TLS,接入点到出口之间用什么协议、有没有加密,用户是看不到的。
AES-256 全程加密 + 不保留日志
AI 专用隧道在接入层到出口节点之间也做 AES-256 加密,和用户侧的 TLS 叠加起来形成双层加密。出口节点不保留请求日志——意味着即便出口节点被攻陷,攻击者也拿不到历史 prompt 和 API Key。
分层密钥与前向保密
每个会话的加密密钥都是临时生成的,会话结束即销毁。哪怕未来某一天长期主密钥泄露,历史会话也无法被回放。这个特性在"合规敏感"的企业场景里尤其重要。
一眼看清:AI 专用隧道 vs 通用方案
| 维度 | AI 专用隧道(TonBo) | 通用安全隧道 |
|---|---|---|
| 路由决策 | 按 AI 服务商地理分布 + 实时链路质量 | 按节点负载和 ping 值 |
| 长连会话 | 会话保活,10+ 小时不断流 | 节点切换需重连 |
| 加密规格 | AES-256 全程 + 前向保密 | 仅 TLS |
| 日志留存 | 出口节点不保留请求日志 | 视服务商策略 |
| 首包延迟 | 100-200ms 稳定 | 200-500ms 波动 |
| 附加能力 | 50+ 大模型统一对话 + Token API | 仅网络通道 |
什么时候用 AI 专用隧道、什么时候用通用方案
- 你主要用 AI 工具:AI 专用隧道性价比明显更高,订阅内含隧道 + 对话 + Token API 三项
- 你偶尔用 AI、主要做其他访问:通用方案也够用,AI 场景体验一般
- 你在做 Agent 开发:AI 专用隧道几乎是唯一选择,长连稳定性差一个数量级
- 你对隐私极度敏感:AES-256 全程加密和出口不留日志是硬需求
选对了隧道,AI 对话才不掉线
不是所有的"安全隧道"都适合跑 AI 流量。TonBo 是专为 AI 场景定制的安全隧道,订阅内含 50+ 大模型统一对话与 OpenAI 兼容 Token API。下载客户端免费试用,亲自感受路由策略、长连和加密规格带来的差异。