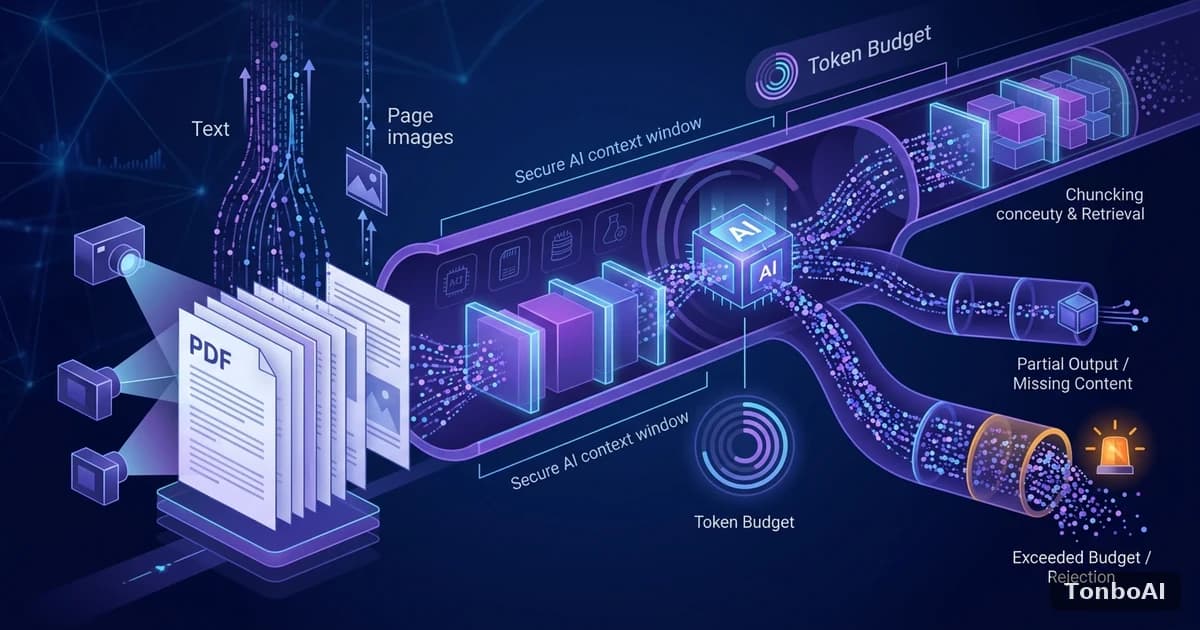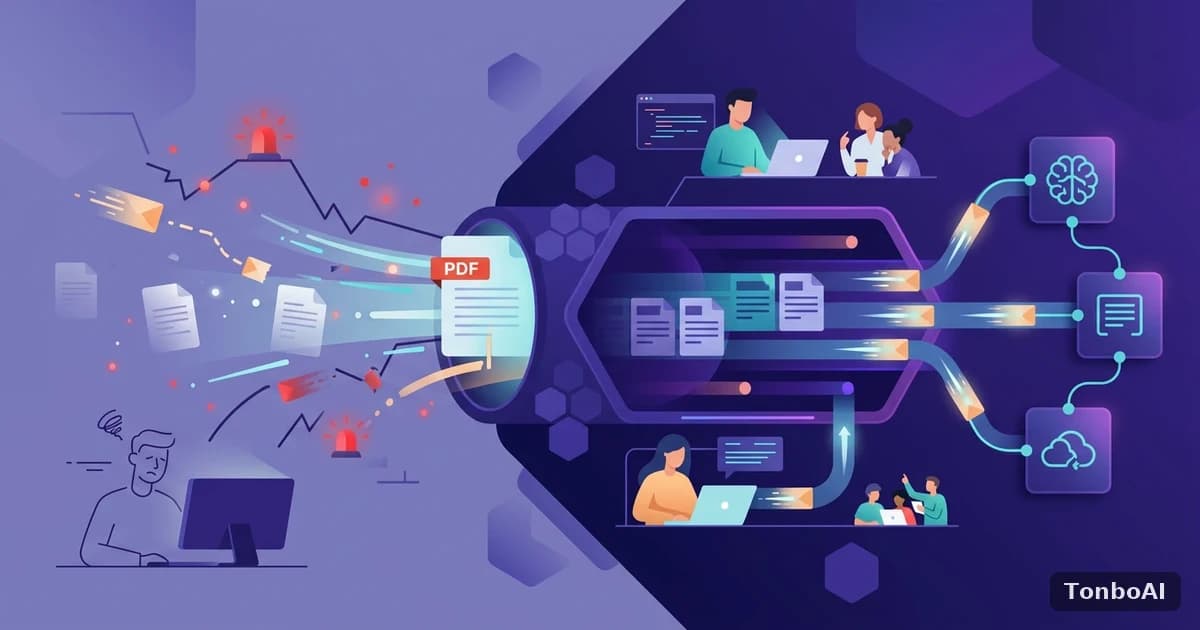
把一份 50 页的 PDF 喂给 Claude,等了十几秒,连接断了,这几美元的调用费就这么没了。这种事如果一周发生三五次,问题已经不在模型,而在你和模型之间那条网络。
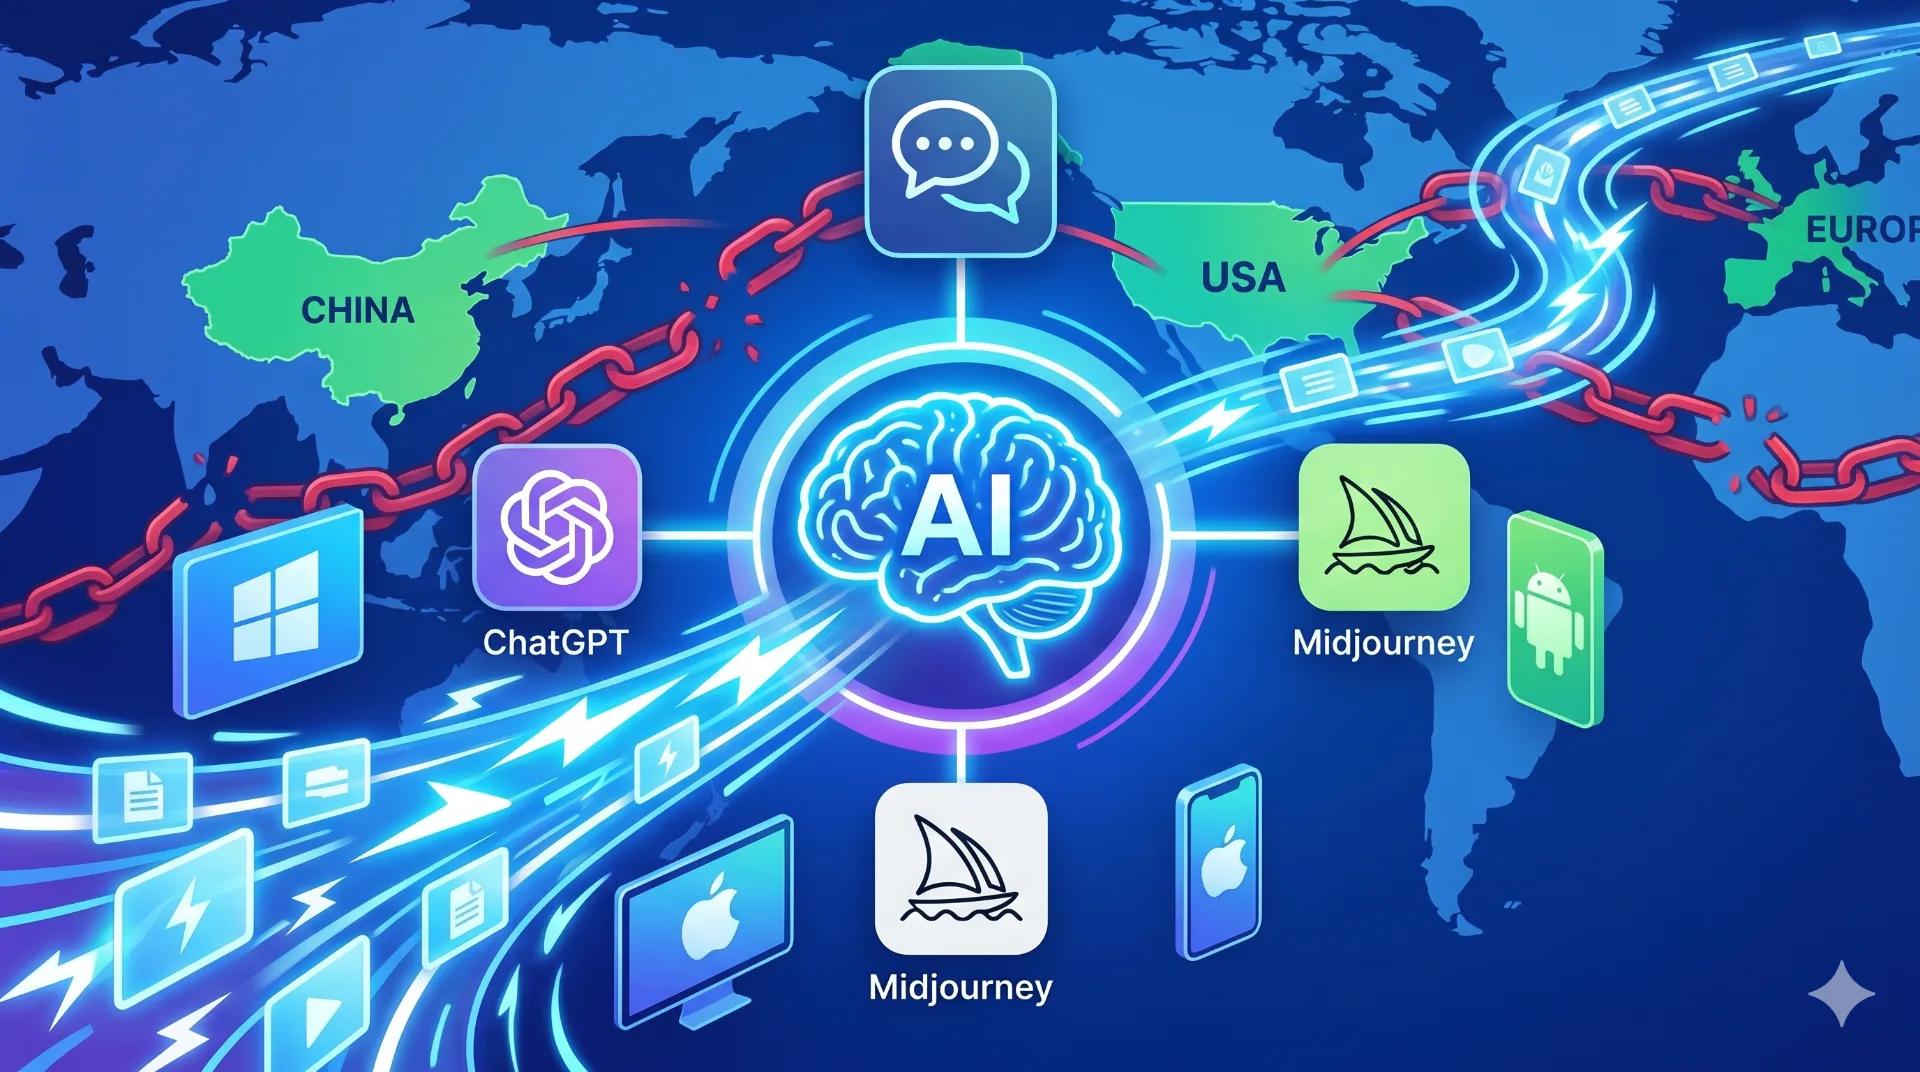
过去一年多,大模型的上下文从几千 token 涨到二十万,多模态又把单次请求的数据量顶了上去。同一条网络,以前传几句话没事,现在传一大段上下文就开始转圈、重置。所谓 AI 专线,说白了就是把这条路从「能连上」改造成「连得稳、回得快」——它针对的不是泛泛的网速,而是 AI 服务那套高频短请求加超长连接的特殊脾气。
到底是谁在搜「AI 专线」
翻一圈搜索这个词的人,大致是两拨,中间还夹着一小撑特殊场景。他们卡的地方各不相同。
一个人单干的创作者和开发者
自由撒稿人、独立开发者、做 AI 原生产品的小作坊。流程通常是:素材在 Notion 里堆好,API 批量喂给 GPT 或 Claude 出初稿,再用 Stable Diffusion 配图。出事的地方几乎都在批处理——单次请求带着几十页上下文,普通网络传到一半断了,重试、再断、再重试,时间和钱一起烧。这群人要的其实很简单:一条能扳住长连接、不会传一半掉链子的路。
散在各地的远程技术团队
成员一个在本地、一个在新加坡、一个在海外大洋彼岸,这种配置现在太常见了。他们要共享 Cursor 的补全会话,要在 Figma 上对着同一份稿子实时评论,还要在 Linear 里追跨时区的任务。这些工具底层都靠 WebSocket 长连接撑着,公共网络下连接频繁漂移,结果就是一个人改了另一个人半天看不到,协同状态对不上。AI 专线在这儿的作用,是用 anycast 路由把几地成员收敛到同一个逻辑接入点,把物理距离造成的会话割裂磨平一些。
还有研究和数据标注的场景
高校实验室、数据供应商要常态访问 Hugging Face、Papers with Code、Colab。这类活儿不怎么吃带宽,但对出口 IP 的「干净程度」特别敏感:公共代理那点 IP 池早被各家平台拉过黑名单,一访问就弹验证码或者直接限流。住宅 IP 混合部署能把「这是数据中心流量」的判定概率压下来一些,验证码自然少弹。
这条路到底优化在哪
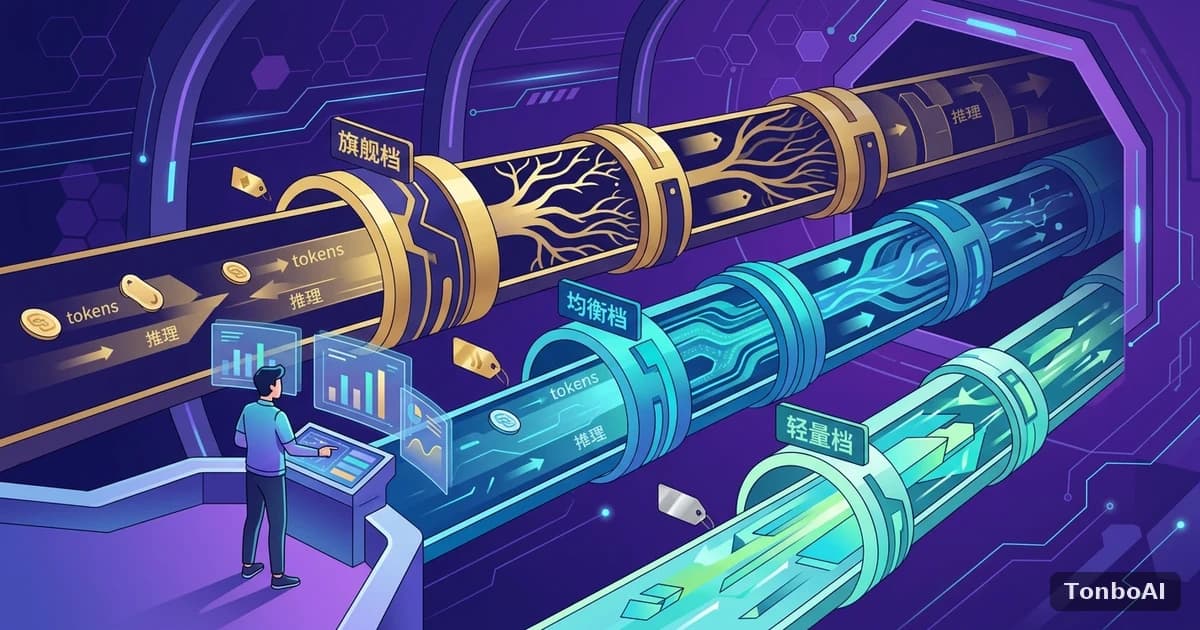
抛开宣传话术,值得盯的就三个数:首包延迟、长连接保持率、丢包之后的重传效率。前两个最能说明问题。
首包延迟也就是 TTFB,普通网络访问 OpenAI 的 API,这个数中位数大概落在 800 到 1200 毫秒,抖动还经常飘过 300 毫秒;调优过的专线能把它压到 200 到 400 毫秒,抖动收在 50 毫秒上下。长连接更能见真章:一段持续两小时的 Claude 长文本会话,专线方案的连接重置率能压到 0.3% 以下,公共代理普遍是 5% 起步——后者意味着平均每聊一会就得重来一次。
传输层默认走 QUIC 而不是 TCP,弱网下队头阻塞能少四成左右。手机从 WiFi 切到蜂窝那一下,QUIC 的连接迁移让 IP 变了也不用重新握手,会话接着用,这点对通勤路上还在跟模型对话的人很实在。
节点不是越多越好
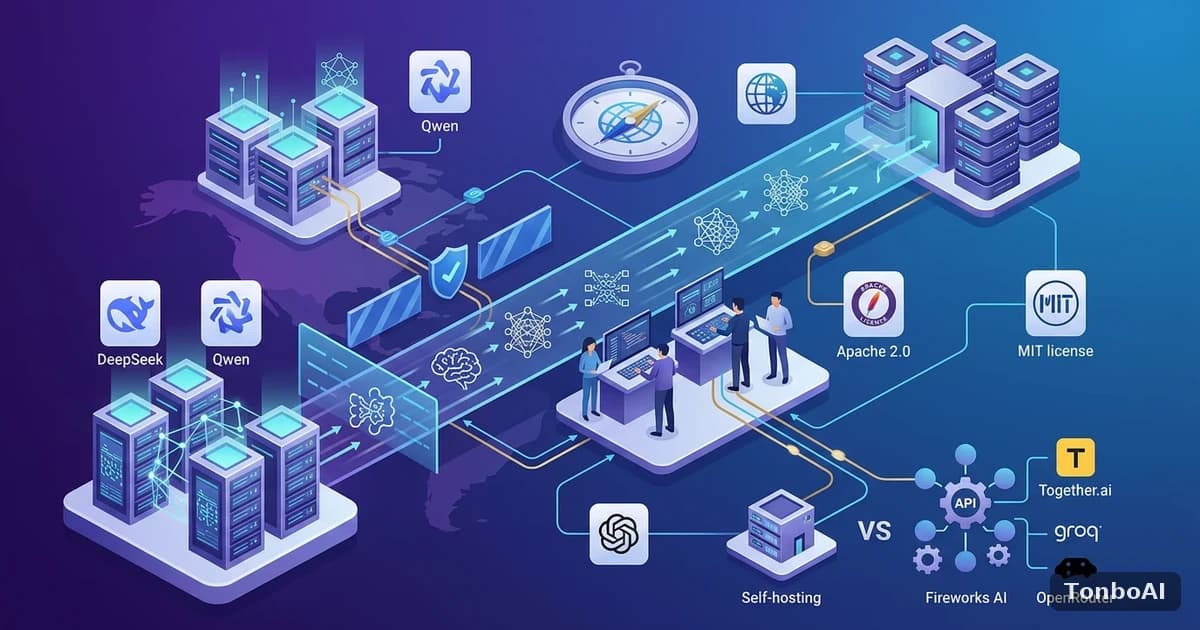
很多人选服务先数节点数量,其实方向反了。节点摆在哪,得跟着 AI 平台的机房走才有意义。OpenAI 主力集群在美西的圣何塞、凤凰城和美东的弗吉尼亚一带,Anthropic 偏美西,Gemini 横跨爱荷华、俄勒冈和比利时。接入点压在这几个区域,再在香港、新加坡、东京摆几个亚太跳板压低首次握手延迟,这套布局就够用了。盲目堆一百个拥挤的廉价节点,反而把流量挤进同一批被标记的 IP 里。
Tonbo AI 现在覆盖 15 个核心城市,美西的洛杉矶、圣何塞、西雅图三城做了双上联,单个接入点挂了大概 3 秒切走。客户端按延迟自动挑路,不用手动去点哪条线。
客户端得跟得上你的设备
AI 这套活儿天然跨设备,桌面、手机、有时还连着路由器,客户端覆盖不全就处处别扭。Tonbo AI 的几个端各有侧重:
- Windows 版能接管系统代理,还能转发 WSL2 的流量,本地跑 LangChain 时自动走专线;
- macOS 版针对 Apple Silicon 调过,菜单栏挂个常驻图标,工作和非工作模式一下切换;
- iOS 和 Android 支持按应用分流——只让 ChatGPT、Claude、Perplexity 这几个走优化通道,刷个网页该直连还直连,不绕远。
愿意折腾的可以用 WireGuard 手动接,刷了 OpenWrt 或 Merlin 固件的路由器能让全屋设备一起覆盖。还有个 CLI 版本输出 JSON,塞进自动化脚本或者 CI 流程里很顺手。
顺手把协同工具也优化了
AI 工具很少单独用,它的价值都长在现有工作流里。Figma、FigJam 的实时协作吃低延迟 WebSocket,专线给这类流量留了优先级队列;Notion、Linear 的同步改成连上就批量补,少在前台干等;GitHub 那种大文件传输开多线程分段,既跑满带宽又不至于触发单流限速。企业部署还能按组配策略,设计组优先保 Figma、工程组优先保代码补全,撞车了由管理员预设的权重说了算。
跟免费方案比,差在哪
下面这张表只挑最影响日常的几项对照,数字都按持续使用一段时间的实测口径写。
| 看的点 | Tonbo AI 专线 | 免费公共代理 |
| 稳不稳 | 99.5% 可用性,长连接保持率 99.7% 以上 | 没保障,高峰频繁超时,重置率 5% 到 15% |
| 接入点 | 15 个核心城市、60 多个接入点,美西美东欧洲亚太都有 | 多数 3 到 10 个,拥挤,IP 重复率高 |
| 客户端 | Windows、macOS、iOS、Android、路由器、CLI 全有 | 多半只给一种协议配置,得自己手搬 |
| 隐私 | 零日志、内存态运行,不落盘 | 说不清,常见流量日志或夹带广告 |
| 协同适配 | 预先调过 Figma、Notion、Linear、代码托管等 20 多个工具 | 没专门优化,WebSocket 常断,多人协作卡 |
免费方案最坑的不是慢,是没法预测。同一个接入点上午顺得很,下午就瘫,工作节奏根本立不起来。IP 被平台标记后触发异常验证,严重的会连累账号。还有更隐蔽的:个别免费工具拿自签名证书截流量,等于把你和模型之间的对话摆在别人面前。说到底,专线买的是确定性,把网络这个变量变成常量而已。
几个真会被问到的问题
专线跟普通加速器,差别真有那么大?
普通加速器是奔着「通用流量能访问、够快」去设计的。专线盯的是 AI 那几个特定动作:API 调用那种高频短连接、长上下文撑起来的长连接、流式返回的实时性。协议栈上做的事包括 TLS 指纹处理、HTTP/2 多路复用,还有跟着 OpenAI、Anthropic 服务端脾气调过的拥塞控制。打个不太严谨的比方:加速器是把路拓宽,专线是在这条路上单划一条救护车道,顺便把红绿灯配时也改了。
我一个人用,值得上专线吗?
看强度。要是每月 API 花销过了 50 美元,网络抽风导致的失败重试已经在实打实地烧钱,那这笔投入能回得来;要是偶尔聊两句,真不必。团队的话更建议走组织级网关,出口 IP 统一了方便在各平台挂白名单,摊到每个人头上反而更省。
手机上会不会被系统限制得很死
不会。iOS 和 Android 都是原生客户端,不用 sideload 也不用企业证书。iOS 走 Network Extension 实现系统级代理,要 iOS 15 以上;Android 10 以上,VPN 模式和应用分流两种随便挑。后台保活专门调过,切个应用连接不断,通勤路上接着跟 Claude 聊不掉线。
怎么判断它到底适不适合我的活儿?
先把现在的底数记下来再说,别拍脑袋。比如连着调 100 次 OpenAI API 的成功率,一段超过 10 万 token 的 Claude 长对话能不能完整跑完,Figma 多人改稿时延迟到底有多明显。拿这几个数对照试用期间的表现,省下来的时间一算就清楚了。Tonbo AI 给 7 天完整功能体验,刚好够覆盖一个完整工作周去验。
数据安全这块怎么兆底
专线是传输层的服务,不碰应用层内容。加密用 ChaCha20-Poly1305,密钥每小时换一轮;服务器坚持内存态运行,不往磁盘写,重启就清空;无日志这件事走过独立审计核验。企业用户还能选私有部署,把接入点放进自己的 VPC 里。
选网络这事越来越像挖云服务——不是买不买,而是配得合不合身。专线不治百病,它解的是特定人在特定场景下对确定性的那点刚需。如果你每月泡在 AI 工具上的时间已经过了二十小时,网络早就成了瓶颈,那花一周时间拿真实工作流跑一遍 Tonbo AI,比看任何参数表都管用。